Tách truy vấn không tự giải quyết thiếu hụt ngữ cảnh. Kỹ thuật này có thể giúp hệ thống tìm đúng tài liệu. Tuy nhiên, bằng chứng vẫn có thể bị loại khi nhiều ý định con cùng cạnh tranh một ngân sách token cố định. Theo The New Stack, thay đổi chính sách phân bổ làm độ bao phủ tăng 20,5 điểm. Mức này cao hơn mức tăng 12,7 điểm khi nâng cấp bộ truy xuất.
Trong phân tích gốc của The New Stack, tác giả gọi hiện tượng này là “context starvation”, tức thiếu hụt ngữ cảnh. Bài viết dưới đây diễn giải lại thí nghiệm và kết quả cho độc giả Việt Nam, đồng thời giữ nguyên toàn bộ số liệu của nguồn.
Một truy vấn có năm yêu cầu nhưng chỉ một yêu cầu được giữ lại
Theo The New Stack, hệ thống trong ví dụ mở đầu tìm được bằng chứng cho cả năm yêu cầu. Tuy nhiên, nó chỉ đưa bằng chứng của một yêu cầu vào ngữ cảnh cuối cùng. Quy trình không tách truy vấn giữ được ba trong năm đoạn. Kết quả cho thấy truy xuất tốt hơn không đồng nghĩa với độ bao phủ ngữ cảnh cao hơn.
Thí nghiệm bắt đầu bằng một tiện ích trò chuyện dùng tài liệu công khai của GitLab. Một lập trình viên gửi cùng lúc năm yêu cầu: khoản thanh toán bị từ chối, số ghế vượt hạn mức, số phút tính toán được chuyển sang kỳ sau, thay đổi người nhận hóa đơn và giới hạn tốc độ giao diện lập trình ứng dụng.
Mỗi yêu cầu đều có một đoạn cụ thể trong tài liệu GitLab trả lời chính xác. Các đoạn này đã được gắn nhãn trước, nên người làm thí nghiệm biết hệ thống đúng phải tìm được gì.
Bằng chứng bị loại ở bước đóng gói
Quy trình được triển khai theo cách thường thấy: tách thông điệp thành năm truy vấn con, truy xuất độc lập, hợp nhất kết quả, loại các đoạn gần trùng nhau, xếp hạng lại theo thông điệp ban đầu rồi đưa những đoạn có điểm cao nhất vào ngữ cảnh dài 2.000 token.
Hệ thống tìm được cả năm đoạn đúng, nhưng chỉ một đoạn còn lại trong ngữ cảnh đã đóng gói. Bốn đoạn kia bị chấm điểm rồi loại bỏ trước khi mô hình nhìn thấy. Cùng thông điệp đó, quy trình không tách truy vấn giữ được ba trong năm đoạn.
Thiếu hụt ngữ cảnh khác lỗi truy xuất như thế nào
Thiếu hụt ngữ cảnh xảy ra khi một ý định con không nhận được bằng chứng trong ngữ cảnh cuối cùng, kể cả khi bộ truy xuất đã tìm thấy bằng chứng đó. Đây là lỗi phân bổ tài nguyên sau truy xuất, không phải lỗi tìm kiếm tài liệu.
Nếu đoạn trả lời câu hỏi thứ năm đã vào nhóm ứng viên nhưng bị ba đoạn liên quan đến câu hỏi thứ nhất đẩy ra ngoài, ý định thứ năm vẫn bị bỏ đói. Trong khi đó, chỉ số thu hồi của bộ truy xuất vẫn có thể báo rằng hệ thống hoạt động hoàn hảo.
Phân biệt với pha loãng và nhiễm độc ngữ cảnh
Hiện tượng này cần được phân biệt với hai lỗi khác:
- Pha loãng ngữ nghĩa xuất hiện trong lúc truy xuất. Một câu hỏi gồm năm phần có thể được biểu diễn bằng một vectơ duy nhất. Vectơ đó có thể nằm giữa năm chủ đề nhưng không đủ gần chủ đề nào. Bằng chứng vì thế không được tìm thấy. Tách truy vấn có thể khắc phục vấn đề này.
- Nhiễm độc ngữ cảnh liên quan đến nội dung đã lọt vào cửa sổ ngữ cảnh. Thông tin sai, cũ hoặc mang tính đối kháng làm hỏng đầu ra của mô hình. Đây là vấn đề ô nhiễm, còn thiếu hụt ngữ cảnh là vấn đề vắng mặt.
Phép so sánh với lập lịch trong hệ điều hành
Khái niệm thiếu hụt được mượn từ hệ điều hành. Trong lập lịch, một tiến trình đã sẵn sàng vẫn có thể chờ vô thời hạn vì hàm ưu tiên liên tục chọn công việc khác. Quy trình truy xuất cũng có tài nguyên cố định, nhiều nhu cầu cạnh tranh và một chính sách quyết định nhu cầu nào được phục vụ.
Bộ đóng gói tham lam theo độ liên quan giống cơ chế lập lịch ưu tiên không có quy tắc tăng dần ưu tiên theo thời gian. Công việc hợp lệ nhưng có mức ưu tiên thấp có thể không bao giờ được chọn.
Tách truy vấn sửa đúng phần đầu nhưng bỏ ngỏ phần sau
Tách truy vấn làm rõ từng ý định và có thể tăng tỷ lệ thu hồi, nhưng không làm cửa sổ ngữ cảnh lớn hơn. Khi các nhóm kết quả được hợp nhất và xếp hạng lại, một ý định có nhiều đoạn đạt điểm cao vẫn có thể chiếm chỗ của các ý định khác.
Khi thông điệp được chia thành năm truy vấn đơn ý định, từng truy vấn tạo biểu diễn rõ hơn và tỷ lệ thu hồi theo truy vấn con tăng. LlamaIndex có công cụ chia truy vấn phức tạp thành câu hỏi con rồi tổng hợp câu trả lời. LangChain tạo nhiều biến thể truy vấn và hợp nhất các kết quả duy nhất. Kỹ thuật hợp nhất thứ hạng đối ứng kết hợp danh sách kết quả của từng truy vấn.
Nút thắt chuyển sang bước đóng gói
Nhưng cửa sổ ngữ cảnh không lớn thêm. Sau khi tách, hệ thống có nhiều nhóm kết quả cùng tranh một ngân sách token cố định. Một quy trình sản xuất phổ biến sẽ hợp nhất các nhóm, loại đoạn gần trùng, xếp hạng lại theo truy vấn gốc rồi tham lam chèn từng đoạn cho đến khi hết chỗ.
Chuỗi thao tác đó thực chất là một bộ lập lịch. Điểm của bộ xếp hạng lại đóng vai trò hàm ưu tiên nhưng không kèm ràng buộc công bằng. Một ý định con có ba đoạn đạt điểm cao có thể chiếm ba vị trí, còn ý định chỉ có một đoạn đúng ở giữa bảng xếp hạng có thể không nhận được vị trí nào.
Chỉ số truy xuất có thể che giấu thất thoát
Lỗi vì thế không biến mất. Nó chuyển từ bước tạo biểu diễn, nơi đội kỹ thuật thường đo lường, sang bước đóng gói, nơi khả năng quan sát kém hơn. Tỷ lệ thu hồi theo truy vấn con có thể tăng cùng lúc với độ bao phủ trong ngữ cảnh cuối cùng giảm. Đây cũng là một ví dụ về việc xác minh từng khâu thay vì chỉ nhìn chỉ số tổng.
Thiết kế thí nghiệm
Thí nghiệm tách riêng hai câu hỏi: bộ truy xuất có tìm thấy bằng chứng đúng hay không, và bằng chứng đó có được giữ trong ngữ cảnh cuối cùng hay không. Khoảng cách giữa hai phép đo cho biết phần thất thoát do chính sách phân bổ.
Theo The New Stack, tập dữ liệu gồm tài liệu công khai của GitLab với 10.000 đoạn và 2,2 triệu token. Nội dung được cắt theo ranh giới tiêu đề, mỗi đoạn dài tối đa 480 token.
Bộ câu hỏi có 61 câu đơn ý định thuộc chín chủ đề, từ quản lý ghế đến giới hạn tốc độ. Mỗi câu được gắn với một đoạn trả lời đúng. Các truy vấn đa ý định được tạo bằng cách ghép câu hỏi, với số ý định lần lượt là 2, 3, 5 và 7. Thứ tự được xáo trộn để vị trí không bị lẫn với chủ đề. Một nửa truy vấn lấy câu hỏi trong cùng chủ đề, nửa còn lại trải qua nhiều chủ đề khác nhau.
Thiết kế này tạo ra 100 truy vấn, gồm 25 truy vấn cho mỗi mức số ý định. Mỗi ý định được ghi nhận hai lần: bằng chứng đúng có vào nhóm ứng viên hay không, và bằng chứng đó có sống sót trong ngữ cảnh cuối cùng hay không. Khoảng cách giữa hai lần ghi nhận chính là phần thất thoát do phân bổ.
Điều kiện để một câu hỏi được đưa vào phép đo
Theo The New Stack, một câu hỏi chỉ được đưa vào thí nghiệm nếu đoạn đúng nằm trong 10 kết quả đầu khi truy vấn riêng lẻ. Điều kiện này được kiểm tra dưới cả hai cấu hình truy xuất. Hai cấu hình đều đạt tỷ lệ thu hồi 100% ở 10 kết quả đầu. Vì nhóm ứng viên của mỗi truy vấn con chính là 10 kết quả đầu, mọi bằng chứng bị mất sau đó đều do bộ đóng gói, không phải do bộ truy xuất.
Phép đo cốt lõi không dùng mô hình ngôn ngữ. Do truy vấn được ghép từ các câu hỏi con đã biết, bộ tách được coi như một bộ tách lý tưởng để kết quả có thể tái lập mà không cần khóa giao diện lập trình ứng dụng.
Kiểm tra bằng bộ tách dùng mô hình ngôn ngữ
Theo The New Stack, tác giả cũng thử một mô hình ngôn ngữ không được biết trước số ý định. Mô hình bất đồng với nhãn chuẩn ở 41% truy vấn, nhưng khi kiểm tra, nó đúng trong mọi trường hợp. Theo cùng phép kiểm tra, năm trong số 61 câu được cho là đơn ý định thực ra chứa hai nhu cầu thông tin. Sau khi điều chỉnh năm câu đó, mức đồng thuận đạt 100 trên 100.
Kết quả này không chứng minh bộ tách thực tế luôn đáng tin cậy. Các truy vấn thử nghiệm được nối bằng liên từ cố định, nên chỉ cần tách theo liên từ cũng có thể khôi phục đúng số ý định. Tin nhắn thực tế thường không rõ ràng như vậy.
Chính sách phân bổ tạo ra khác biệt lớn hơn
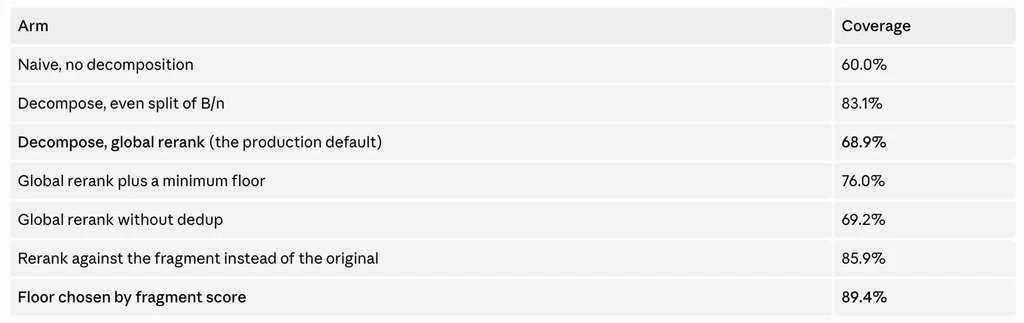
Theo The New Stack, ở ngân sách 2.000 token trên cấu hình mạnh, quy trình mặc định làm thiếu hụt 31,1% ý định con. Cũng theo kết quả này, chọn đoạn dành trước theo từng truy vấn con nâng độ bao phủ lên 89,4%. Tỷ lệ thiếu hụt do phân bổ giảm từ 30,6% xuống 10,1%.
Các cấu hình được đem ra so sánh
Theo The New Stack, mỗi phương án được chạy với ngân sách 2.000, 4.000 và 8.000 token trên hai cấu hình truy xuất. Cấu hình mạnh ghép BAAI/bge-base-en-v1.5 với BAAI/bge-reranker-base. Cấu hình yếu dùng bản lượng tử hóa BAAI/bge-small-en-v1.5 cùng Xenova/ms-marco-MiniLM-L-6-v2.
Việc truy xuất dùng độ tương đồng cosin trong bộ nhớ trên mảng NumPy. Với 10.000 đoạn, tác giả nhận định cơ sở dữ liệu vectơ sẽ mất nhiều thời gian viết và chạy hơn, đồng thời khó kiểm tra hơn.
Theo The New Stack, ở ngân sách 2.000 token trên cấu hình mạnh, quy trình mặc định làm thiếu hụt 31,1% ý định con dù bằng chứng đã được tìm thấy. Độ bao phủ của quy trình mặc định cao hơn cách không tách truy vấn chín điểm. Cách chia đều ngân sách theo số ý định có độ bao phủ cao hơn quy trình mặc định 14 điểm.
Dành chỗ đúng nhưng chọn đoạn sai
Theo The New Stack, việc dành trước một đoạn cho mỗi ý định con đáp ứng 99,4% số chỗ đã đặt nhưng chỉ tăng bảy điểm. Nguyên nhân là hệ thống dành chỗ đúng cơ chế nhưng chọn sai đoạn, do đoạn được chấm theo toàn bộ truy vấn gốc.
Theo The New Stack, khi đoạn dành trước được chọn theo mức liên quan với chính truy vấn con, độ bao phủ tăng lên 89,4%. Theo cùng kết quả, tỷ lệ thiếu hụt do phân bổ giảm từ 30,6% xuống 10,1%. Tác giả cho biết thay đổi này chỉ cần khoảng bốn dòng mã.
Theo The New Stack, xếp hạng theo truy vấn gốc kém xếp hạng theo mảnh truy vấn 17 điểm. Theo cùng phép đo, các đoạn gần trùng chỉ tiêu thụ 1,0% ngân sách. Việc loại chúng chỉ làm độ bao phủ thay đổi 0,3 điểm. Kết quả này cho thấy loại trùng vẫn hữu ích nhưng không phải nguyên nhân chính khiến một câu hỏi bị bỏ qua.
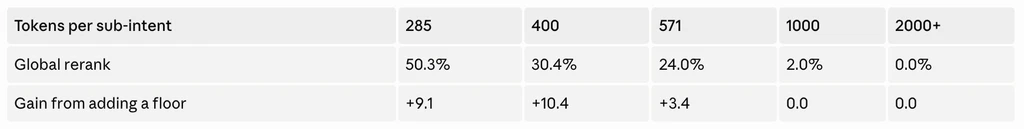
The New Stack ghi nhận một ngưỡng rõ ràng. Dưới khoảng 1.000 token cho mỗi ý định con, chính sách phân bổ chi phối kết quả. Trên ngưỡng đó, các phương án phân bổ gần như không còn khác biệt vì mọi đoạn cần thiết đều có thể vừa ngữ cảnh.
Bộ truy xuất yếu vẫn có thể thắng nếu phân bổ tốt
Theo The New Stack, bộ truy xuất yếu kết hợp chính sách phân bổ theo truy vấn con đạt độ bao phủ 84,5%, cao hơn 16 điểm so với mức 68,9% của bộ truy xuất mạnh dùng bộ đóng gói tham lam.
So sánh tác động của truy xuất và phân bổ
Theo kết quả của The New Stack, nâng cấp bộ truy xuất làm độ bao phủ của quy trình mặc định tăng từ 56,2% lên 68,9%, tương đương 12,7 điểm. Giữ nguyên bộ truy xuất nhưng đổi chính sách phân bổ làm độ bao phủ tăng từ 68,9% lên 89,4%, tức 20,5 điểm.
So sánh trực tiếp còn rõ hơn: bộ truy xuất yếu kết hợp mức sàn chấm theo truy vấn con đạt 84,5%, cao hơn 16 điểm so với mức 68,9% của bộ truy xuất mạnh đi cùng bộ đóng gói tham lam. Trong thí nghiệm này, bộ truy xuất kém hơn nhưng bộ phân bổ tốt hơn vẫn thắng.
Kết quả đó phù hợp với một nguyên tắc rộng hơn trong vận hành hạ tầng trí tuệ nhân tạo: chất lượng của cả hệ thống không chỉ phụ thuộc vào thành phần mạnh nhất mà còn phụ thuộc vào cách tài nguyên được chuyển qua từng bước.
Vị trí và khoảng cách chủ đề cũng làm thay đổi tỷ lệ thiếu hụt
Các ý định ở giữa một truy vấn dài bị bỏ qua thường xuyên hơn ý định ở đầu hoặc cuối. Theo The New Stack, với bảy ý định, các yêu cầu trải trên nhiều chủ đề có tỷ lệ thiếu hụt 38,1%. Mức này gần gấp đôi tỷ lệ 18,3% của nhóm cùng chủ đề.
Ảnh hưởng của vị trí trong truy vấn
Với truy vấn có bảy ý định, The New Stack giữ cố định số ý định để độ khó không ảnh hưởng phép so sánh. Theo số liệu của The New Stack, tỷ lệ thiếu hụt theo bảy vị trí lần lượt là 1,3%, 21,3%, 30,7%, 48,0%, 48,0%, 32,0% và 13,3%.
Đây là đường cong theo vị trí nối tiếp. Bộ đóng gói bảo vệ tốt nhất phần được hỏi đầu tiên, bảo vệ phần cuối ở mức thấp hơn và thường loại các phần ở giữa. Theo The New Stack, khi dùng mức sàn chấm theo truy vấn con, các tỷ lệ lần lượt còn 4,0%, 9,3%, 6,7%, 8,0%, 22,7%, 5,3% và 6,7%.
Ảnh hưởng của khoảng cách chủ đề
Khoảng cách chủ đề cũng tạo ra khác biệt. Theo The New Stack, với bảy ý định, nhóm trải trên nhiều chủ đề bị thiếu hụt 38,1%. Mức này gần gấp đôi tỷ lệ 18,3% của nhóm cùng một chủ đề. Tác giả ban đầu dự đoán điều ngược lại.
Một truy vấn nhất quán về chủ đề cho bộ xếp hạng lại mục tiêu rõ ràng, nên các đoạn đúng nhận điểm tương đối gần nhau. Truy vấn phân tán khiến bộ xếp hạng bám vào một số chủ đề rồi bỏ các chủ đề còn lại.
Người dùng nhận được nội dung gì khi bằng chứng biến mất
Theo The New Stack, khi bằng chứng đúng có mặt, mô hình xử lý ý định tương ứng trong 261 trên 261 trường hợp. Khi bằng chứng bị thiếu, mô hình vẫn trả lời trong 48,1% trường hợp. Kết quả cho thấy thiếu hụt ngữ cảnh có thể tạo ra câu trả lời không có bằng chứng thay vì một khoảng trống dễ phát hiện.
Cách đo tác động ở đầu ra
Theo The New Stack, tác giả tạo câu trả lời hỗ trợ từ 80 ngữ cảnh đã đóng gói để kiểm tra tác động ở đầu ra. Mỗi câu trả lời được chấm theo từng ý định con. Cả bước tạo câu trả lời lẫn bước chấm đều không biết ngữ cảnh đến từ phương án nào.
Theo The New Stack, khi bằng chứng đúng có mặt trong ngữ cảnh, câu trả lời xử lý câu hỏi tương ứng ở 261 trên 261 trường hợp. Tỷ lệ này đạt 100% trong cả hai phương án. Kết quả chỉ cho thấy quan hệ một chiều: khi bằng chứng đúng có mặt, ý định luôn được xử lý trong thí nghiệm; khi bằng chứng bị thiếu, mô hình vẫn có thể trả lời mà không có hỗ trợ.
Thiếu bằng chứng thường không dẫn đến im lặng
Theo The New Stack, khi một ý định bị thiếu bằng chứng, mô hình vẫn trả lời trong 48,1% trường hợp dựa trên nội dung khác còn lại trong cửa sổ. Theo cùng phép đo, mô hình chủ động báo thiếu thông tin trong 45,6% trường hợp và chỉ im lặng ở 6,3% trường hợp.
Rủi ro chính không phải mô hình bỏ trống câu trả lời. Mô hình thường tiếp tục trả lời mà không có bằng chứng hỗ trợ. Thí nghiệm mới đo xem câu hỏi có được xử lý hay không, chưa đo câu trả lời đó đúng hay sai.
Nguồn cũng nêu một số giới hạn. Truy vấn ghép sạch hơn tin nhắn hỗ trợ thực tế, vốn có đại từ, ngữ cảnh ngầm và mệnh đề điều kiện. Thí nghiệm chỉ dùng một tập tài liệu và một họ mô hình biểu diễn. Nhãn chuẩn được soạn với sự hỗ trợ của mô hình rồi do tác giả tự kiểm tra. Mô hình viết câu trả lời thuộc loại mạnh, nên một mô hình rẻ hơn trong sản xuất có thể ít báo thiếu dữ liệu hơn và tự tạo thông tin nhiều hơn.
Một bộ phân bổ phù hợp cần làm gì
Bộ phân bổ nên dành ít nhất một vị trí cho mỗi ý định con, chọn đoạn dành trước theo mức liên quan với chính truy vấn con và ghi lại ý định nào không nhận được bằng chứng. Xếp hạng toàn bộ đoạn theo truy vấn gốc không bảo đảm công bằng giữa các ý định.
Giải pháp được kết quả ủng hộ là dành mức sàn cho từng ý định con, sau đó chọn đoạn dành trước theo điểm đối với chính ý định đó. Không nên chọn đoạn theo mức liên quan với toàn bộ thông điệp.
Xếp hạng và giám sát theo từng ý định
Bước xếp hạng lại cũng nên dùng mảnh truy vấn thay vì truy vấn gốc. Điểm của các mảnh khác nhau không nhất thiết so sánh trực tiếp được, nhưng đặc điểm này lại có ích: kết quả tốt nhất của mỗi truy vấn con đứng đầu thang điểm riêng, qua đó tạo ra mức công bằng theo ý định.
Loại đoạn gần trùng vẫn đáng làm, song dữ liệu trong thí nghiệm cho thấy phần gần trùng chỉ chiếm 1,0% ngân sách. Dành nhiều tuần tối ưu bước này sẽ không giải quyết được câu hỏi thứ năm bị bỏ rơi.
Hệ thống nên ghi lại độ bao phủ theo từng ý định con. Một ý định nhận được không đoạn nào là tín hiệu trực tiếp rằng mô hình sắp trả lời điều không có bằng chứng. Cách giám sát này cũng gần với yêu cầu phải đặt lỗi trí tuệ nhân tạo vào đúng bối cảnh ưu tiên, thay vì chỉ quy trách nhiệm cho mô hình ở cuối chuỗi.
Khi các ý định phụ thuộc lẫn nhau
Tách truy vấn song song không đủ cho các câu hỏi có điều kiện vì mục tiêu truy xuất của một ý định có thể phụ thuộc vào câu trả lời của ý định khác. Hai hướng xử lý được đề xuất là gắn nhãn quan hệ phụ thuộc hoặc chạy thêm một lượt truy xuất sau khi điều kiện ban đầu đã được giải quyết.
Cách tách song song không xử lý tốt câu hỏi có điều kiện như: nếu giao hàng muộn thì tôi có được hoàn tiền không? Câu này có hai ý định, nhưng mục tiêu truy xuất của ý định thứ hai phụ thuộc vào câu trả lời của ý định thứ nhất.
Nếu coi hai ý định là ngang hàng, hệ thống có thể lấy chính sách giao hàng muộn và chính sách hoàn tiền chung. Nó lại bỏ lỡ đoạn quy định riêng về hoàn tiền khi giao hàng muộn, vì đoạn này có thể không khớp mạnh với bất kỳ truy vấn con nào.
Hai hướng xử lý quan hệ phụ thuộc
Có hai hướng xử lý. Hệ thống có thể gắn nhãn quan hệ phụ thuộc ngay khi tách truy vấn, hoặc chạy lượt truy xuất thứ hai cho mệnh đề điều kiện sau khi vòng đầu đã giải quyết điều kiện.
Tác giả nghiêng về gắn nhãn phụ thuộc vì ba lý do. Lượt thứ hai tốn thêm một vòng truy xuất trong ngân sách độ trễ vốn hạn chế của trợ lý hỗ trợ. Nhãn phụ thuộc có thể được tái sử dụng để ngăn ý định phụ thuộc giữ chỗ khi ý định cha chưa được giải quyết. Lỗi gắn nhãn cũng hiện rõ dưới dạng một ý định bị thiếu trong tín hiệu bao phủ.
Tuy nhiên, đây là đề xuất thiết kế chứ chưa phải kết quả đã đo. Gắn nhãn phụ thuộc đẩy thêm công việc sang bộ tách, vốn đã là thành phần yếu nhất trong chuỗi. Thí nghiệm chưa so sánh trực tiếp phương án có và không có nhãn.
Chỉ số nên đo ngay trong hệ thống sản xuất
Chỉ số trực tiếp nhất là tỷ lệ ý định con không nhận được đoạn nào trong ngữ cảnh cuối cùng. Hệ thống cũng nên theo dõi ngân sách token trên mỗi ý định và so sánh độ bao phủ trước, sau bước đóng gói thay vì chỉ đo tỷ lệ thu hồi của bộ truy xuất.
Phép tính đầu tiên rất đơn giản: lấy ngân sách ngữ cảnh chia cho số câu hỏi riêng biệt trung bình trong mỗi thông điệp đến. Theo The New Stack, nếu kết quả thấp hơn khoảng 1.000 token cho mỗi ý định, chính sách phân bổ có thể gây tổn thất lớn hơn chất lượng của bộ truy xuất.
Đối chiếu trên dữ liệu sản xuất
Trên tập dữ liệu thử nghiệm, nâng cấp bộ truy xuất tăng 12,7 điểm độ bao phủ, còn thay đổi cách phân bổ tăng 20,5 điểm. Đây là kết quả có thể kiểm chứng trên từng tập dữ liệu riêng, không phải một ngưỡng chắc chắn đúng cho mọi hệ thống.
Với mỗi yêu cầu đa ý định, đội vận hành có thể ghi lại bao nhiêu ý định con không nhận được đoạn nào trong ngữ cảnh cuối cùng. Nếu hệ thống không biết mình đã bỏ câu hỏi nào, mô hình vẫn có thể trả lời câu hỏi đó khoảng một nửa số lần bằng những gì tình cờ còn lại trong cửa sổ.
Nếu đang vận hành hệ thống truy xuất tăng cường, hãy đo độ bao phủ theo từng ý định trước khi mua thêm năng lực truy xuất.