Nvidia dùng lượng tử hóa hai bit để đưa mô hình tác tử Nemotron 3.5 Bolt 74B vào 24GB bộ nhớ. Mỗi lần xử lý chỉ kích hoạt 9 tỷ tham số. Mô hình chạy cục bộ các tác vụ lập trình, nghiên cứu và hội thoại trên máy cá nhân. Nvidia cũng công bố Nemotron 3.5 Super VL 120B và phiên bản Bolt E4B 4GB dành cho thiết bị nhỏ hơn.
Phát hiện chính
Nemotron 3.5 Bolt 74B-A9B 24GB kết hợp kiến trúc hỗn hợp chuyên gia với độ chính xác hỗn hợp để giảm yêu cầu bộ nhớ. Theo The New Stack, Bolt kích hoạt 9 tỷ trong tổng số 74 tỷ tham số và hướng tới tác vụ tác tử chạy cục bộ trên laptop.
Nội dung
Nvidia công bố ba thành viên mới của dòng Nemotron vào thứ Năm. Nemotron 3.5 Super VL xử lý văn bản, hình ảnh, video và tài liệu cho tác tử doanh nghiệp. Hai mẫu Bolt nhỏ hơn hướng tới công việc cục bộ, gồm lập trình, nghiên cứu và hội thoại.
Theo Nvidia, các mẫu Bolt được thiết kế cho tác vụ tác tử hằng ngày trên laptop. Chúng cân bằng tốc độ với khả năng suy luận nhiều bước, gọi công cụ và duyệt web. Đây cũng là nhóm công việc thường gặp ở một tác tử AI hỗ trợ lập trình. Hai mô hình lớn hơn đã được phát hành, còn Bolt E4B 4GB sẽ xuất hiện trong thời gian tới.
Super VL kết hợp suy luận với xử lý hình ảnh
Nemotron 3.5 Super VL có 120 tỷ tham số, trong đó 12 tỷ tham số hoạt động khi suy luận. Theo Nvidia, cửa sổ ngữ cảnh đạt tối đa 1 triệu đơn vị văn bản. Mô hình hiểu văn bản, hình ảnh, video và tài liệu, đồng thời hỗ trợ suy luận và sử dụng công cụ, nhưng không tạo hình ảnh hoặc video.
Kari Briski, Phó chủ tịch phụ trách mô hình mở và phần mềm của Nvidia, cho biết Super VL hướng tới độ chính xác hàng đầu trong các tác vụ tác tử đa phương thức. Phạm vi này gồm làm theo chỉ dẫn, sử dụng công cụ, xử lý quy trình kinh doanh nhiều bước và hiểu nội dung trực quan.
Nvidia cho rằng hiệu năng của Super VL có thể so sánh với mô hình suy luận lớn nhất của hãng dù số tham số chỉ bằng khoảng một phần năm. Đây là tuyên bố của Nvidia dựa trên các phép đánh giá do hãng công bố, không phải kết quả kiểm chứng độc lập.
Super VL được phát triển từ Nemotron 3 Super, mô hình ra mắt vào tháng 3. Cả hai có 120 tỷ tham số tổng cộng và 12 tỷ tham số hoạt động khi suy luận. Super VL bổ sung bộ mã hóa thị giác để tiếp nhận hình ảnh và video bên cạnh văn bản.
Kết quả không đồng đều khi so với Qwen
Kết quả do Nvidia công bố cho thấy Super VL không dẫn đầu trong mọi phép đo. Mô hình vượt Qwen3.5-122B-A10B về suy luận khoa học và tác vụ đầu cuối, nhưng thấp hơn một chút trên SWE-bench Verified và bài đánh giá khả năng hiểu tài liệu.
| Phép đo | Super VL | Qwen3.5-122B-A10B |
|---|---|---|
| Terminal-Bench | 66,7 | 48,7 |
| SWE-bench Verified | 71,1 | 71,9 |
| Tổng tham số | 120 tỷ | 122 tỷ |
| Tham số hoạt động | 12 tỷ | 10 tỷ |
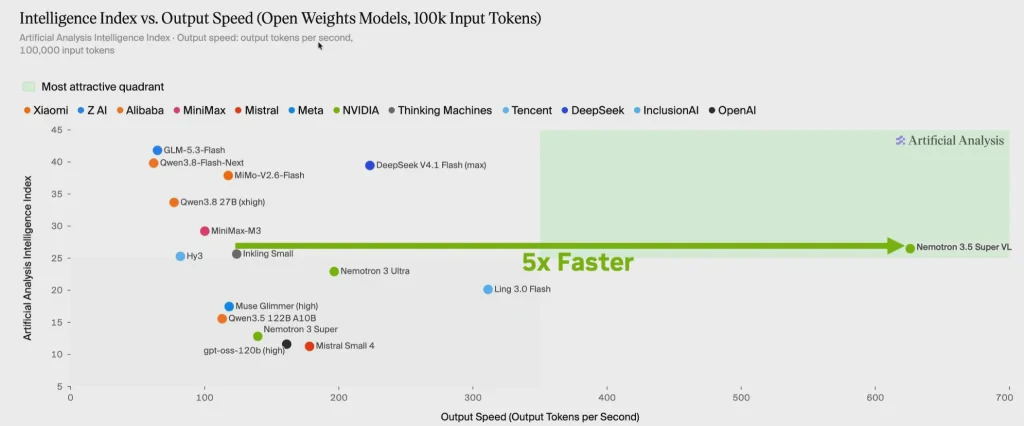
Năm phép đo trong so sánh của Nvidia gồm GPQA-Diamond, Terminal-Bench 2.1, SWE-bench Verified, IFBench và MMLongBench-Doc. Qwen3.8-Flash-Next đạt điểm cao hơn Super VL trong cả năm phép đo, nhưng các thành phần nhúng và dự đoán bổ sung đưa tổng quy mô của mô hình này lên khoảng 180 tỷ tham số.
Inkling-Small của Thinking Machines có 276 tỷ tham số tổng cộng và 12 tỷ tham số hoạt động. Theo so sánh của Nvidia, Inkling-Small thấp hơn Super VL ở tác vụ đầu cuối nhưng cao hơn ở khả năng làm theo chỉ dẫn.
Nvidia cũng báo cáo Super VL vượt Nemotron 3 Ultra trong các đánh giá hành vi Hermes Bench và LangChain. Theo số liệu Nvidia công bố, điểm Hermes Bench là 63,44% đối với Super VL và 56,33% đối với Nemotron 3 Ultra. Theo cùng nguồn số liệu, điểm LangChain tương ứng là 87,05% và 84,3%.
Tốc độ là trọng tâm của Super VL
Nvidia tập trung Super VL vào tốc độ xử lý tác vụ và tạo văn bản. Theo hãng, mô hình hoàn thành 10.000 tác vụ SWE-bench Pro nhanh gấp bốn lần khi chạy trên bốn GPU B200, dù biểu đồ của Nvidia cho thấy độ chính xác thấp hơn Qwen3.8-Flash-Next và DeepSeek V4 Flash.
Kiến trúc lai của Super VL kết hợp Mamba-2, cơ chế chú ý, các lớp hỗn hợp chuyên gia và một bộ mã hóa thị giác. Nvidia tiếp tục huấn luyện mô hình ngôn ngữ bằng phương pháp chưng cất từ Nemotron 3 Ultra. Sau đó, hãng huấn luyện thêm cho kỹ nghệ phần mềm, thị giác và tác vụ tác tử. Cách triển khai này thuộc bài toán rộng hơn về hạ tầng AI và cách vận hành tài nguyên tính toán.
Để tăng tốc tạo văn bản, Nvidia sử dụng LiLiCorr, một kỹ thuật giải mã suy đoán. Một mô hình hỗ trợ nhỏ tạo trước nhiều đơn vị văn bản, sau đó Super VL kiểm tra chúng cùng lúc thay vì sinh từng đơn vị riêng lẻ. Nvidia cho biết LiLiCorr tăng tốc độ tạo văn bản trên DGX Spark lên tới 2,3 lần so với giải mã không suy đoán.
Với quy trình xử lý tài liệu, Nvidia tập trung Super VL vào nhận dạng ký tự quang học, bảng, biểu đồ và thông tin có cấu trúc. Trên CharXiv, phép đo khả năng suy luận từ biểu đồ, Nvidia báo cáo độ chính xác 80,8% cho Super VL và 63% cho Nano Omni. Khi bổ sung diễn giải mã Python, kết quả của Super VL tăng lên 84%.
Bolt đưa 74 tỷ tham số vào 24GB bộ nhớ
Nemotron 3.5 Bolt 74B-A9B 24GB dùng kiến trúc hỗn hợp chuyên gia với 74 tỷ tham số tổng cộng và 9 tỷ tham số hoạt động trong mỗi lần xử lý. Nvidia dùng lượng tử hóa hai bit cho các chuyên gia trong mô hình để giảm yêu cầu bộ nhớ xuống 24GB.
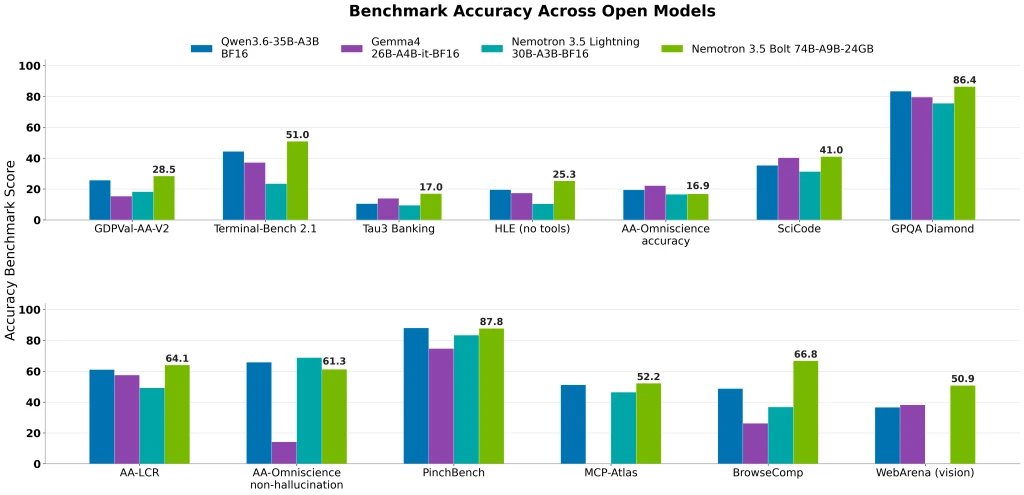
Theo thử nghiệm của Nvidia trên Terminal-Bench 2.1, Bolt đạt 51,0 điểm. Qwen3.6-35B-A3B đạt 44,4 điểm và Gemma4 26B-A4B đạt 37,2 điểm. Hai mô hình đối chiếu được thử nghiệm với định dạng BF16, trong khi Bolt dùng độ chính xác hỗn hợp, gồm các chuyên gia hai bit.
Nvidia đang tối ưu Bolt cho hệ thống RTX Spark và DGX Spark. Mô hình cũng hỗ trợ llama.cpp, Ollama, LM Studio và vLLM.
Khả năng chạy cục bộ giúp Bolt giảm phụ thuộc vào hạ tầng từ xa, nhưng lựa chọn mô hình vẫn gắn với tranh luận rộng hơn về AI mở và AI đóng của Nvidia. Nvidia phát hành các mô hình mới trên Hugging Face theo giấy phép OpenMDW 1.1, cho phép sử dụng thương mại và sửa đổi.
Phiên bản 4GB dành cho thiết bị nhỏ hơn
Nemotron 3.5 Bolt E4B 4GB là phiên bản dành cho phần cứng có bộ nhớ hạn chế hơn. Nvidia dự kiến phát hành mô hình vào cuối tháng và hướng Bolt E4B tới tác tử hội thoại cùng tác tử vật lý chạy trên GeForce RTX, Jetson và Spark.
Các trường hợp sử dụng được Nvidia nêu gồm trợ lý trên thiết bị và nhân vật tương tác. Những hệ thống này cần gọi công cụ qua nhiều lượt hội thoại và nhận biết trạng thái hiện tại của ứng dụng.
Hãy theo dõi Sine để cập nhật các thử nghiệm thực tế khi Nemotron 3.5 Bolt được triển khai trên phần cứng cá nhân.
