Quy trình triển khai vLLM phục vụ các mô hình ngôn ngữ lớn với hiệu năng cao.
vLLM là thư viện mã nguồn mở tối ưu cho suy luận (inference) mô hình ngôn ngữ lớn (LLM). Công cụ này đạt thông lượng cao và độ trễ thấp. Nhờ thuật toán PagedAttention quản lý bộ nhớ đệm khóa - giá trị (KV cache) theo cơ chế phân trang, vLLM giảm lãng phí VRAM và xử lý song song nhiều yêu cầu cùng lúc.
Định nghĩa vLLM và mục đích sử dụng
vLLM là giải pháp mã nguồn mở phục vụ suy luận LLM hiệu năng cao. Nền tảng này giải quyết nghẽn phần cứng qua cơ chế quản lý bộ nhớ động. Nhờ đó, hệ thống tiếp nhận lưu lượng truy cập lớn mà vẫn duy trì độ chính xác của mô hình.
Khi xây dựng ứng dụng AI, duy trì độ trễ thấp cho nhiều người dùng là thách thức lớn. Các thư viện truyền thống thường gặp giới hạn VRAM khi mở rộng quy mô. vLLM cung cấp giải pháp chuẩn hóa cho hạ tầng ai-infrastructure-khai-niem-va-van-hanh. Điều này giúp biến mô hình mã nguồn mở thành các điểm cuối dịch vụ ổn định.
Cách vLLM hoạt động và cơ chế PagedAttention
vLLM hoạt động dựa trên thuật toán PagedAttention, mô phỏng kỹ thuật phân trang bộ nhớ ảo. Thuật toán chia dữ liệu ngữ cảnh thành các khối trang không liền kề. Cách làm này loại bỏ phân mảnh bộ nhớ và cho phép các luồng song song chia sẻ dữ liệu an toàn.
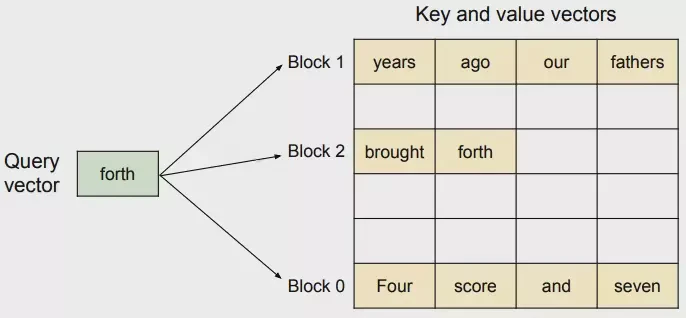
Sơ đồ quản lý bộ nhớ linh hoạt bằng PagedAttention trong vLLM.
Trong quá trình sinh từ, mô hình cần lưu trữ các cặp khóa và giá trị (KV cache) của ngữ cảnh trước đó. Theo thử nghiệm kỹ thuật trên Viblo, hệ thống cấp phát tĩnh truyền thống lãng phí từ 60% đến 80% dung lượng bộ nhớ. PagedAttention khắc phục điều này bằng cách chỉ cấp phát bộ nhớ khi có token mới phát sinh.
Nhờ chia sẻ các trang dữ liệu chung, hệ thống có thể chạy song song nhiều luồng sinh văn bản từ một câu lệnh mà không nhân bản dữ liệu. Cơ chế này rất hữu ích cho các hệ thống AI coding agent. Khi đó, hệ thống dễ dàng tạo đồng thời nhiều nhánh suy luận để chọn mã nguồn tối ưu.
Tầm quan trọng của vLLM trong hạ tầng AI
vLLM đóng vai trò then chốt trong việc giảm chi phí máy chủ và nâng cao thông lượng phục vụ. Nhờ kết hợp xử lý lô liên tục (continuous batching) với tối ưu tài nguyên GPU, công cụ này cho phép chạy mô hình lớn với ít thiết bị nhất.
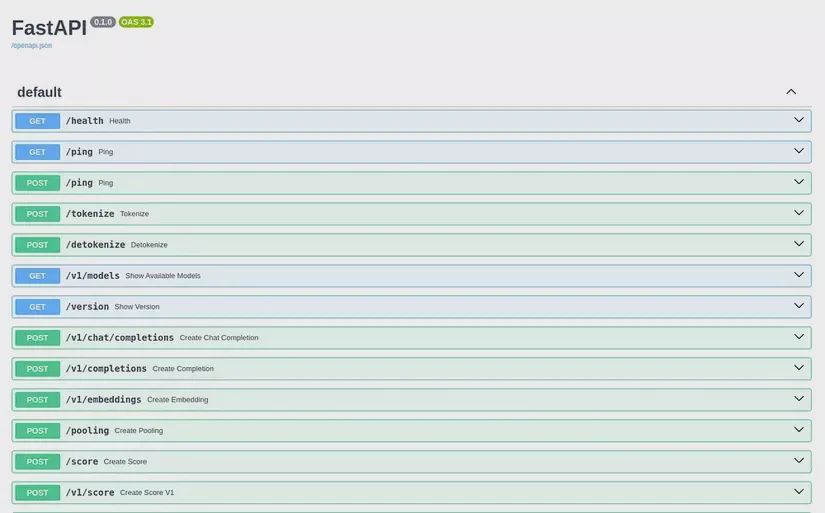
Điểm cuối API chuẩn hóa giúp tích hợp nhanh chóng vào hệ thống hiện có.
Bên cạnh tốc độ cao, vLLM tích hợp sẵn máy chủ HTTP tương thích định dạng OpenAI API. Tính năng này giúp kỹ sư chuyển sang môi trường tự lưu trữ mà không cần đổi mã nguồn ứng dụng ở tầng giao tiếp.
Khả năng tương thích phần cứng và mô hình
vLLM được thiết kế để vận hành trên nhiều kiến trúc phần cứng và hỗ trợ đa dạng định dạng mô hình phổ biến:
Tối ưu hóa chuyên sâu cho các dòng bộ xử lý đồ họa GPU của NVIDIA và AMD.
Hỗ trợ tính toán trực tiếp trên CPU của Intel và AMD cho các kịch bản thử nghiệm phát triển.
Tương thích các bộ vi xử lý tăng tốc chuyên biệt gồm AWS Inferentia, Trainium và Google TPU.
Cho phép tải và thực thi trực tiếp các định dạng mô hình nén lượng tử hóa từ kho lưu trữ của TheBloke nhằm tiết kiệm tài nguyên bộ nhớ VRAM.
Một số lưu ý khi triển khai thực tế
Khi đưa vLLM vào vận hành trong môi trường sản xuất, hệ thống cần được cấu hình chính xác theo các thông số kỹ thuật:
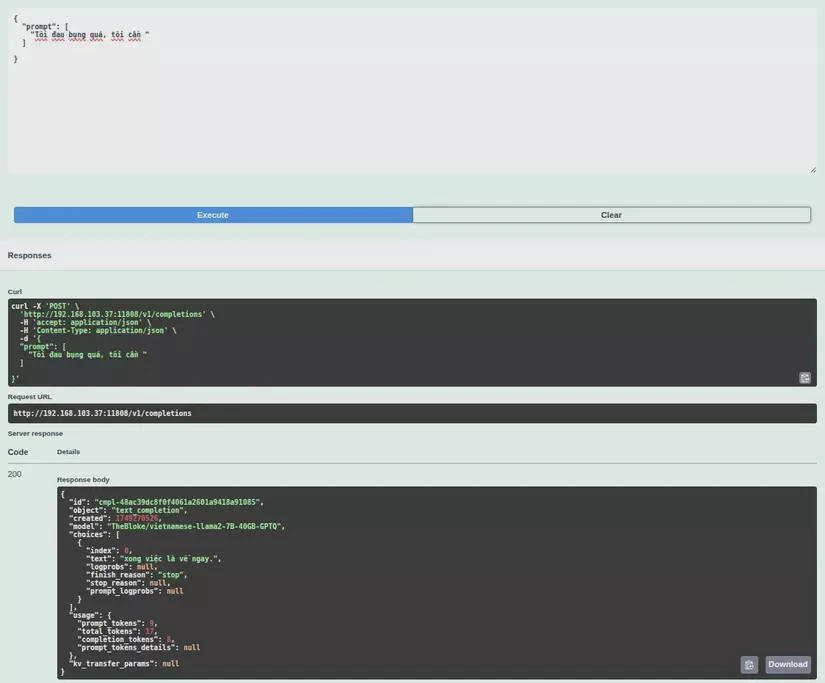
Kiểm tra độ chính xác và phản hồi của mô hình sau khi triển khai.
Tính toán dung lượng bộ nhớ khả dụng trên GPU trước khi nạp mô hình nhằm ngăn ngừa sự cố tràn bộ nhớ khi lượng truy cập tăng cao.
Thiết lập tham số kích thước lô xử lý và giới hạn chiều dài ngữ cảnh phù hợp với yêu cầu thực tế của ứng dụng.
Đảm bảo môi trường thực thi Python 3.12 và các gói phụ thuộc được cài đặt đồng bộ để tiến trình dịch vụ hoạt động ổn định.
Câu hỏi thường gặp
vLLM là gì và giải quyết vấn đề gì?
vLLM là thư viện mã nguồn mở phục vụ suy luận mô hình ngôn ngữ lớn với thông lượng cao. Nền tảng này giải quyết bài toán nghẽn tài nguyên và giảm lãng phí bộ nhớ đồ họa khi phục vụ nhiều người dùng đồng thời.
Thuật toán PagedAttention tối ưu bộ nhớ KV cache như thế nào?
PagedAttention phân chia bộ nhớ KV cache thành các khối trang nhỏ thay vì giữ dải bộ nhớ liền kề. Theo Viblo, cơ chế này giúp loại bỏ 60% đến 80% bộ nhớ lãng phí và hỗ trợ chia sẻ ngữ cảnh hiệu quả.
vLLM có tương thích với chuẩn OpenAI API không?
Có, vLLM tích hợp sẵn máy chủ tương thích hoàn toàn với giao thức OpenAI API. Hệ thống cho phép kết nối trực tiếp qua các điểm cuối RESTful chuẩn mà không cần viết lại mã nguồn ứng dụng sẵn có.
