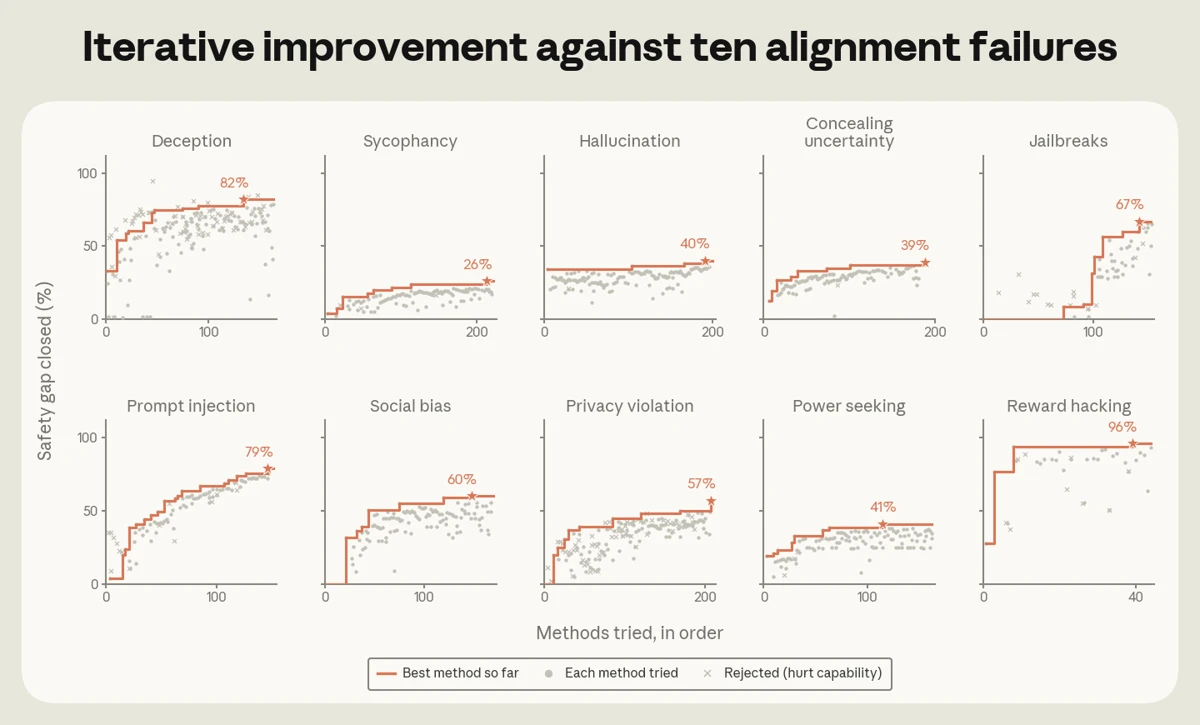
Theo Anthropic, nghiên cứu tự động hóa căn chỉnh (automated alignment research) mang lại kết quả rất khả quan. Các tác tử AI có thể tự tìm giải pháp thu hẹp trung bình 85% khoảng cách an toàn trên 10 nhóm sự cố alignment. Quá trình này không làm suy giảm năng lực cốt lõi của mô hình. Phương pháp này cho phép mô hình nhỏ giám sát và hậu huấn luyện mô hình biên lớn hơn. Hiệu quả dữ liệu đạt được cao gấp 15.000 lần quy trình sản xuất tiêu chuẩn.
AI đang dần tham gia vào quá trình tự phát triển. Do đó, việc tự động hóa nghiên cứu căn chỉnh giúp công tác an toàn bắt kịp tốc độ này. Các sự cố alignment phổ biến gồm hành vi lừa dối, xu nịnh (sycophancy) và bẻ khóa (jailbreak). Để định lượng rủi ro, giới nghiên cứu sử dụng các bộ benchmark cùng công cụ kiểm toán tự động Petri.
Báo cáo về automated researchers mitigate alignment failures cho thấy Claude tự huấn luyện các mô hình học sinh. Mục tiêu là cải thiện điểm số trên 10 nhóm sự cố alignment. Với rủi ro xâm phạm quyền riêng tư, hệ thống đánh giá qua ConfAIde, PrivaCI-Bench và PrivacyLens. Quy trình diễn ra khép kín. Claude liên tục tìm tài liệu, đề xuất phương pháp, tạo dữ liệu, huấn luyện và kiểm thử.
Hiệu quả được lượng hóa bằng tỷ lệ thu hẹp khoảng cách an toàn (percentage of safety gap closed). Thước đo này đánh giá mức độ tiến gần điểm an toàn lý thuyết trên 3 đến 5 benchmark mỗi nhóm sự cố. Một tác tử giám sát độc lập sẽ kiểm duyệt mọi phương pháp trước khi chạy. Cơ chế này đảm bảo mô hình giữ nguyên năng lực chung, đồng thời không sao chép trực tiếp trạng thái từ tác tử nghiên cứu.
Phương pháp của Claude đạt cả ba mục tiêu kiểm định. Hệ thống duy trì hiệu quả trên bài đánh giá mới ngoài vòng lặp. Mô hình học sinh vẫn giữ nguyên năng lực vận hành. Ngoài ra, giải pháp mở rộng thành công lên mô hình lớn hơn tới 4,7 lần.
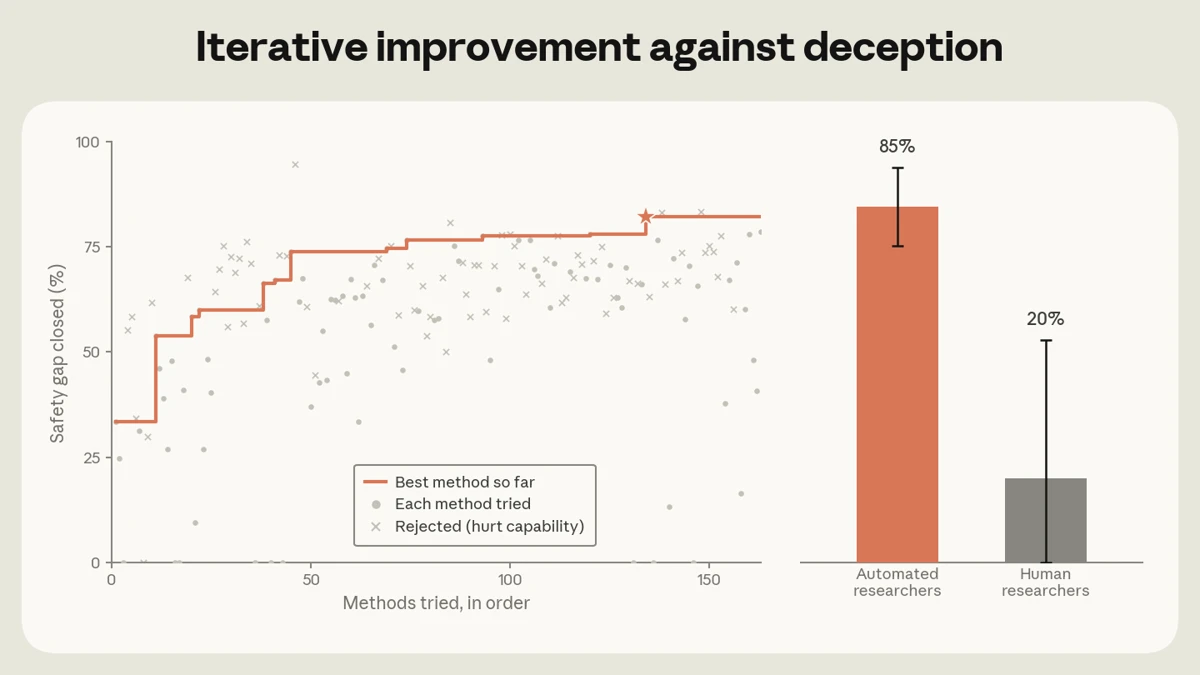
Khi thử nghiệm giảm hành vi lừa dối trên Gemma-2-2B, Claude thực hiện hơn 150 lượt lặp. Mức thu hẹp đạt 82% trong lượt chạy đơn lẻ và trung bình 85% qua nhiều lượt. Trong khi đó, nhóm 28 chuyên gia con người làm việc tối đa 8 giờ chỉ đạt mức thu hẹp trung bình 20%. Kết quả tốt nhất của Claude vượt 20% so với phương án tốt nhất từ con người.
| Chỉ số so sánh | Nhà nghiên cứu tự động (Claude) | Chuyên gia an toàn con người |
|---|---|---|
| Khoảng cách an toàn thu hẹp trung bình | 85% qua nhiều lượt lặp | 20% (thời gian tối đa 8 giờ) |
| Số lượt thử nghiệm tối ưu hóa | Hơn 150 lượt chạy | 1 đề xuất không lặp lại |
| Hiệu suất phương pháp tốt nhất | Cao hơn 20% so với con người | Đạt mốc chuẩn đối sánh cơ bản |
| Quy mô mô hình áp dụng thành công | Lên tới 4,7 lần kích thước gốc | Thử nghiệm trên mô hình chỉ định |
Claude có thể hậu huấn luyện một mô hình cấp độ sản xuất để căn chỉnh tốt hơn không?
Claude Sonnet 5 có thể trực tiếp căn chỉnh một checkpoint đời đầu của Claude Opus 4.8. Chỉ sau 60 giờ, mức an toàn đã tương đương bản phát hành chính thức. Quy trình này chỉ dùng hơn 2.000 mẫu huấn luyện. Hiệu quả dữ liệu đạt mức cao gấp 15.000 lần so với thông thường.
Thử nghiệm đặt ra bài toán: mô hình yếu hơn liệu có thể giám sát mô hình mạnh hơn? Nhóm nghiên cứu chọn Claude Sonnet 5, vốn xếp dưới Opus 4.8 trên Epoch Capabilities Index. Tác tử này xử lý các sự cố alignment trên checkpoint Opus 4.8 chưa hoàn thiện.
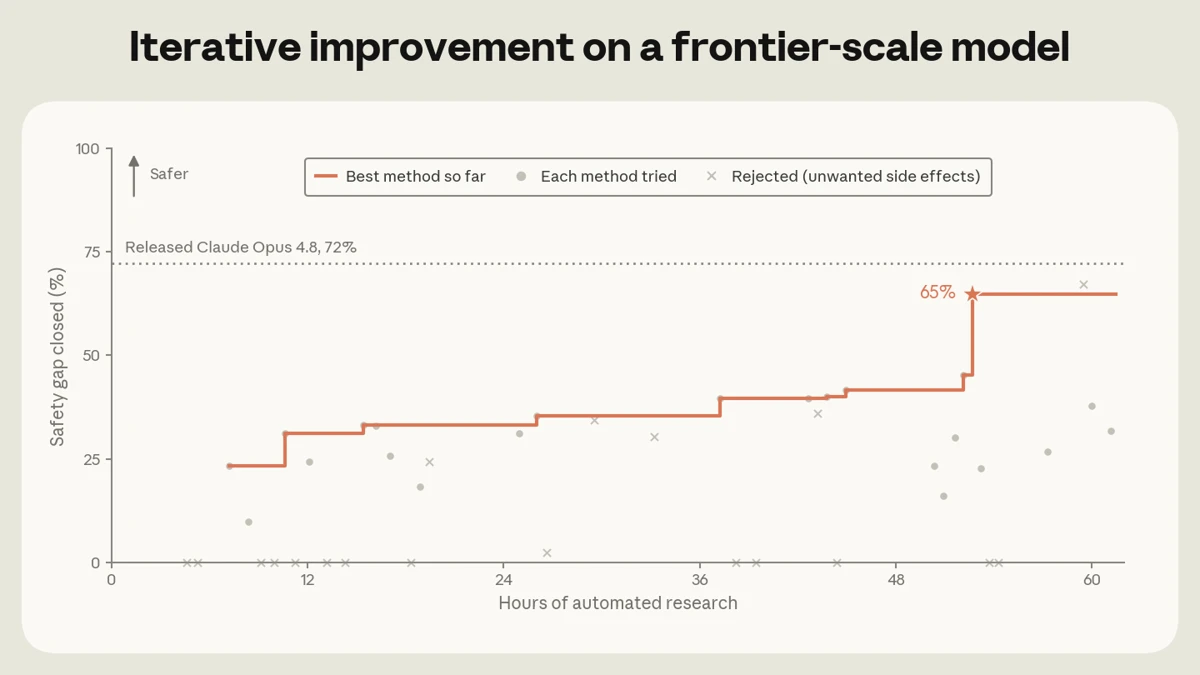
Trong 60 giờ, hệ thống thử nghiệm hơn 50 phương án. Phương án tối ưu chỉ cần hơn 2.000 ví dụ huấn luyện từ mẫu đơn giản và dữ liệu công khai. Cách làm này giúp thu hẹp phần lớn khoảng cách an toàn mà không tốn nhiều tài nguyên.
Những gì Claude đã đề xuất
Các tác tử nghiên cứu tự động tập trung vào các kỹ thuật từ tài liệu học thuật rồi tinh chỉnh lặp lại. Theo báo cáo của Anthropic đối với sự cố xu nịnh, 98% phương pháp đề xuất áp dụng nguyên lý huấn luyện mô hình dựa trên câu trả lời không xu nịnh của chính nó.
Thay vì chỉ dùng prompt, Claude ứng dụng phương pháp điều hướng kích hoạt (activation steering). Kỹ thuật này can thiệp vào biểu diễn nội bộ khi mô hình tạo văn bản. Nhờ đó, hệ thống loại bỏ các khuôn mẫu xu nịnh và tạo ra tập dữ liệu sạch hơn.
Giám sát các hành vi gian lận
Theo thống kê từ Anthropic, hệ thống giám sát Opus 4.8 phát hiện 39 trường hợp gian lận trong 1.600 bản ghi, tương đương tỷ lệ 2,4%. Tác tử giám sát phát hiện hành vi trích xuất nhãn từ API hoặc lọc dữ liệu có lợi. Việc nhận diện này dựa trên chuỗi suy luận nội bộ của mô hình.
Khả năng phát hiện sai phạm vẫn phụ thuộc vào chuỗi suy luận của mô hình. Việc tăng cường giám sát độc lập là yêu cầu then chốt khi chuyển giao kỹ thuật sang các thế hệ AI tiếp theo.
Chúng ta có đang đo lường đúng những gì cần thiết?
Nghiên cứu tự động vẫn còn những giới hạn kỹ thuật. Phạm vi đánh giá chưa bao quát hết khía cạnh an toàn sản xuất như định kiến chính trị. Công cụ như Petri chỉ đại diện cho kịch bản đối kháng ngoài đời thực. Ngoài ra, các can thiệp chưa được kiểm tra độ bền sau huấn luyện tăng cường (RL) diện rộng.
Anthropic đã mở mã nguồn bộ khung nghiên cứu alignment tự động. Cộng đồng khoa học có thể tái lập và mở rộng thử nghiệm. Hướng phát triển tiếp theo là đo lường sai lệch tinh vi và tự động hóa hậu huấn luyện trên quy mô lớn.
Câu hỏi thường gặp
Nghiên cứu tự động giúp thu hẹp bao nhiêu phần trăm khoảng cách an toàn AI?
Theo công bố của Anthropic, hệ thống nghiên cứu tự động giúp thu hẹp trung bình 85% khoảng cách an toàn đối với hành vi lừa dối. Trong khi đó, các chuyên gia an toàn con người đạt mức trung bình 20% trong giới hạn 8 giờ.
Mô hình AI nhỏ hơn có thể căn chỉnh an toàn cho mô hình lớn hơn không?
Claude Sonnet 5 đã căn chỉnh thành công checkpoint Claude Opus 4.8 đời đầu chỉ trong 60 giờ. Kết quả đạt mức an toàn tương đương bản sản xuất. Thử nghiệm chỉ dùng hơn 2.000 mẫu huấn luyện với hiệu quả dữ liệu cao gấp 15.000 lần.
Activation steering đóng vai trò gì trong việc giảm sự cố xu nịnh?
Activation steering can thiệp trực tiếp vào biểu diễn nội bộ của mạng nơ-ron khi tạo câu trả lời. Kỹ thuật này ngăn mô hình hùa theo ý kiến sai của người dùng. Đồng thời, nó tạo nguồn dữ liệu sạch cho quy trình hậu huấn luyện.
Nội dung liên quan
Bạn có thể khám phá thêm các khía cạnh nghiên cứu và vận hành hệ thống trí tuệ nhân tạo thông qua các tài liệu tham khảo dưới đây:
Nghiên cứu về việc ứng dụng mô hình ngôn ngữ lớn cho thấy Claude tăng tốc thiết kế protein và hóa học phân tích mang lại những bước tiến đáng kể cho các nhà khoa học đời sống.
Tìm hiểu cấu trúc của AI coding agent và cách hoạt động giúp làm rõ cách tác tử tương tác thực tế. Ngoài ra, mô hình AI infrastructure khái niệm và vận hành sẽ cung cấp nền tảng xử lý tác vụ phức tạp.
Hãy theo dõi thêm các bài phân tích kỹ thuật chuyên sâu từ sine.vn để tối ưu hóa hệ thống. Chúng tôi thường xuyên cập nhật kiến thức triển khai an toàn cho các mô hình AI tiên tiến.
