Phòng thí nghiệm Siêu trí tuệ của Meta vừa ra mắt Muse Voice Transcribe, mô hình nhận dạng giọng nói được thiết kế riêng cho phiên âm thời gian thực. Theo The New Stack, mô hình mới dẫn đầu một số phép đo độ chính xác. Kết quả này vượt các sản phẩm tương ứng của OpenAI, Google và nhiều công ty chuyên về âm thanh.
Meta gọi đây là mô hình nhận biết âm thanh thời gian thực đầu tiên của hãng. Công ty trước đó đã phát hành Muse Spark với khả năng chuyển giọng nói thành văn bản, nhưng mô hình ấy không tập trung riêng vào nhu cầu này. Muse Voice Transcribe bổ sung thêm một mảnh ghép cho hệ sinh thái tích hợp AI ở quy mô lớn. Trong hệ sinh thái này, tốc độ phản hồi và độ ổn định ảnh hưởng trực tiếp đến trải nghiệm người dùng.
Nội dung: mô hình được huấn luyện trên hơn 70 ngôn ngữ
Theo Meta, Muse Voice Transcribe được huấn luyện trên hơn 70 ngôn ngữ, trong đó 25 ngôn ngữ đã được kiểm chứng kỹ. Mô hình có thể xử lý trường hợp một người đổi ngôn ngữ ngay giữa cuộc trò chuyện, đồng thời hỗ trợ các phiên nói kéo dài hơn một giờ.
Meta cho biết hệ thống còn phân biệt được hơn 20 người nói. Khả năng này phù hợp với các cuộc họp, phỏng vấn hoặc thảo luận nhóm, dù kết quả đo cho thấy nhận diện người nói vẫn là bài toán khó đối với toàn bộ thị trường.
Mô hình hiện có trên Giao diện mô hình Meta, Meta AI dành cho máy Mac và Muse Code. Theo The New Stack, giá sử dụng giao diện là 3 USD cho mỗi 1.000 phút âm thanh, tương đương 0,18 USD mỗi giờ. Meta sẽ không phát hành trọng số mở của mô hình này, khác với cách hãng xử lý dòng Muse Glimmer.
Meta đang dẫn đầu phép đo tiếng Anh
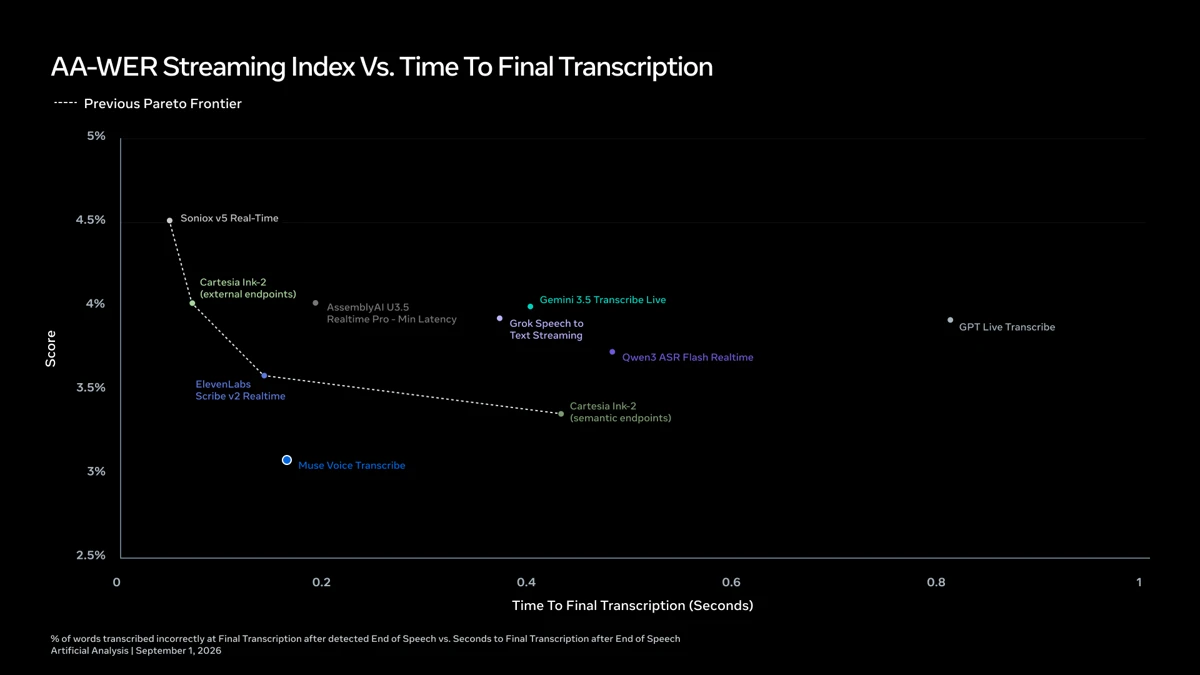
Trong phép đo độ chính xác phiên âm trực tuyến AA-WER Streaming của Artificial Analysis, Muse Voice Transcribe có tỷ lệ lỗi từ là 3,1%. Theo số liệu được The New Stack dẫn lại, Cartesia Ink-2 đạt 3,4%, Scribe v2 Real-time của ElevenLabs đạt 3,6%, GPT Live Transcribe đạt 3,9% và Gemini 3.5 Transcribe Live đạt 4%.
Khoảng cách giữa Meta và đối thủ gần nhất chỉ là 0,3 điểm phần trăm. Quan trọng hơn, phép đo này chỉ áp dụng cho lời nói bằng tiếng Anh. Vì vậy, kết quả 3,1% chưa cho biết mô hình hoạt động chính xác đến đâu với tiếng Việt hoặc các ngôn ngữ khác trong danh sách huấn luyện.
Với nhiệm vụ phân biệt từng người nói, Muse Voice Transcribe đạt tỷ lệ lỗi 17,5% trên một số phép đo tiêu chuẩn, theo Meta. Con số này vẫn khá cao so với mức người dùng có thể mong đợi, nhưng mô hình của Meta hiện đứng đầu nhóm sản phẩm phiên âm thời gian thực được so sánh.
Cơ chế trì hoãn thích ứng hoạt động ra sao
Meta mô tả Muse Voice Transcribe là một mô hình đa phương thức tự hồi quy thuộc họ Muse Spark. Thay vì chờ toàn bộ câu nói kết thúc, hệ thống liên tục quyết định nên xuất văn bản ngay hay nghe thêm âm thanh.
Theo phần giải thích kỹ thuật của Meta được The New Stack thuật lại, âm thanh đi vào theo từng đoạn dài 80 mili giây, tương đương 12,5 đoạn mỗi giây. Mỗi đoạn được nén thành một “soft token”, tức một token biểu diễn mềm dùng bên trong mô hình. Sau khi nhận một đoạn, mô hình có thể tạo ra một mã văn bản hoặc phát tín hiệu yêu cầu đoạn âm thanh tiếp theo.
Khi âm thanh dừng, một mã âm thanh trống báo cho mô hình rằng không còn dữ liệu mới. Hệ thống khi đó xuất phần văn bản còn giữ lại. Cách vận hành này cho phép mô hình tự điều chỉnh lượng ngữ cảnh cần nghe trước khi chốt một từ.
Meta gọi cơ chế đó là trì hoãn thích ứng. Một từ khó có thể khiến mô hình chờ thêm ngữ cảnh, trong khi từ dễ được phiên âm gần như ngay lập tức. Trong giai đoạn học tăng cường, phần thưởng dành cho tỷ lệ lỗi từ và phần thưởng dành cho độ trễ được nhân với nhau thay vì cộng lại. Theo Meta, cơ chế tương tự cũng được dùng để phát hiện người nói.
Lợi thế hiện tại có thể không kéo dài
Phiên âm trực tuyến đang trở thành một mảng cạnh tranh dày đặc. Theo The New Stack, OpenAI, Google, xAI và Alibaba đều phát hành mô hình xử lý luồng âm thanh trong vòng vài tuần. Các hãng này cạnh tranh với những công ty chuyên về công nghệ giọng nói đã hoạt động từ trước.
Với khoảng cách chỉ 0,3 điểm phần trăm so với đối thủ gần nhất trên phép đo tiếng Anh, vị trí dẫn đầu của Meta có thể thay đổi nhanh. Theo The New Stack, Google và OpenAI đã phát hành các mô hình xử lý luồng âm thanh trong vòng vài tuần. xAI và Alibaba cũng đưa ra các mô hình cùng loại trong giai đoạn này.
Meta có động lực riêng để tiếp tục cải thiện công nghệ này. Những sản phẩm quan trọng của hãng, từ kính thông minh đến ứng dụng dành cho máy Mac, đều cần nhận dạng lời nói nhanh và chính xác. Tuy nhiên, với người dùng trong nước, câu hỏi đáng chú ý vẫn là hiệu quả thực tế đối với tiếng Việt, điều mà các số liệu hiện có chưa trả lời.
Hãy theo dõi Sine để cập nhật khi Muse Voice Transcribe có kết quả kiểm thử cụ thể với tiếng Việt.
