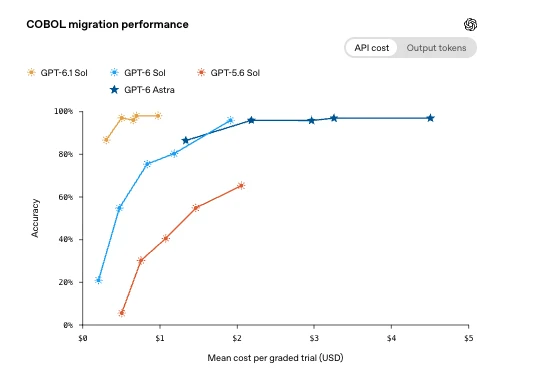
Trong bài đánh giá di chuyển COBOL của OpenAI, GPT-6.1 Sol đạt độ chính xác 86,6% ở mức suy luận thấp. Con số này tăng lên 97,9% ở mức suy luận cao. Kết quả cải thiện mạnh so với mức 5,4% của GPT-5.6 Sol. Tuy nhiên, kết quả chưa thể được xác minh độc lập vì OpenAI chưa công khai bộ kiểm thử COBOL.
Theo bài viết gốc của The New Stack, chi phí của GPT-6.1 Sol ở mức suy luận thấp cũng thấp hơn 39% so với mô hình tiền nhiệm. OpenAI cho biết bài đánh giá đo khả năng chuyển một chương trình hiện có sang ngôn ngữ khác mà vẫn giữ nguyên hành vi.
OpenAI đã công khai cấu hình và bộ kiểm thử MultiLangBench, một phép đánh giá riêng về khả năng xây dựng phần mềm bằng 20 ngôn ngữ lập trình. Sự khác biệt về mức độ công khai khiến kết quả MultiLangBench dễ kiểm tra hơn kết quả di chuyển COBOL.
Nội dung đánh giá hiện đại hóa COBOL
Kết quả của OpenAI cho thấy mô hình mới có thể hỗ trợ chuyển chương trình COBOL sang các ngôn ngữ hiện đại. Mô hình đạt độ chính xác cao trong một bài kiểm thử có kiểm soát. Tuy nhiên, điểm số này chưa chứng minh rằng mô hình có thể tự di chuyển an toàn một hệ thống COBOL đang vận hành.
Theo công bố của OpenAI, bài đánh giá kiểm tra khả năng chuyển chương trình sang C++, Java, Kotlin, Python và Rust mà không làm thay đổi hành vi. Mỗi chương trình sau khi di chuyển phải vượt qua các phép thử ẩn, trong đó đầu ra có thể quan sát phải trùng khớp từng byte.
Độ chính xác và chi phí
GPT-6.1 Sol đạt độ chính xác 86,6% ở mức suy luận thấp và 97,9% ở mức cao. GPT-5.6 Sol chỉ đạt 5,4% trong cùng bài đánh giá, theo số liệu OpenAI được The New Stack dẫn lại.
COBOL vẫn là mục tiêu khó đối với các công cụ lập trình dùng trí tuệ nhân tạo. So với Python và JavaScript, mô hình có ít mã COBOL và tài liệu hơn để học. Lập trình viên COBOL giàu kinh nghiệm cũng khó tìm, còn tài liệu thường không theo kịp những hệ thống mà họ duy trì.
Ảnh hưởng đối với các hệ thống đang vận hành
Quy mô sử dụng làm tăng tác động của bài toán hiện đại hóa. Theo số liệu IBM được The New Stack dẫn lại, COBOL vận hành hơn 40% hệ thống ngân hàng trực tuyến. Ngôn ngữ này cũng hỗ trợ 80% giao dịch thẻ tín dụng trực tiếp và xử lý 95% giao dịch tại máy ATM.
Đối với các đội kỹ thuật đang cân nhắc dùng tác tử lập trình bằng trí tuệ nhân tạo, kết quả trên cho thấy khả năng hỗ trợ mã cũ đang cải thiện. Việc áp dụng vào hệ thống thực tế vẫn đòi hỏi chuyên gia hiểu quy tắc nghiệp vụ, phụ thuộc kỹ thuật và yêu cầu vận hành của từng tổ chức.
Kết quả MultiLangBench trên 20 ngôn ngữ
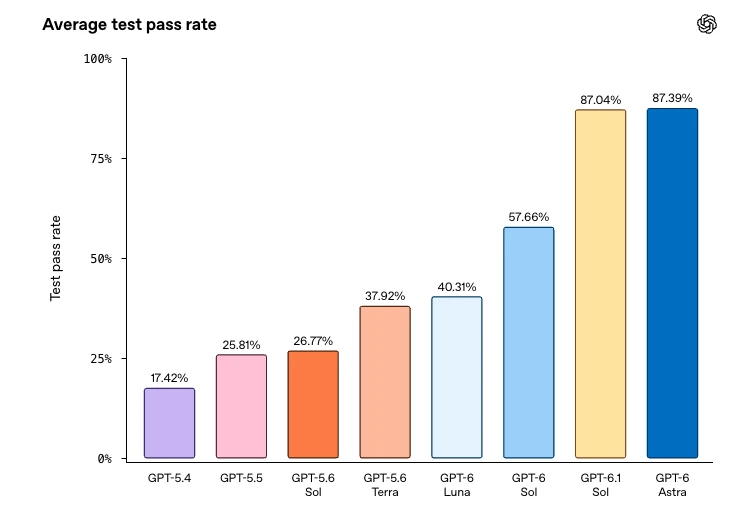
Trong MultiLangBench, GPT-6 Astra đạt tỷ lệ vượt qua kiểm thử trung bình 87,4% trên 20 ngôn ngữ. GPT-5.6 Sol đạt 26,8%. GPT-6 Luna đạt 40,3% và vượt GPT-5.6 Sol ở mọi ngôn ngữ được thử nghiệm. Chi phí giao diện lập trình ứng dụng của Luna được ước tính thấp hơn khoảng 78%.
Cách MultiLangBench kiểm tra mô hình
OpenAI phát triển MultiLangBench để đo khả năng xây dựng phần mềm từ đầu bằng những ngôn ngữ có ít mã nguồn và tài liệu huấn luyện. Trong bài thử, chương trình nhận một cơ sở dữ liệu cùng truy vấn SQL. Sau đó, chương trình tạo ra cơ sở dữ liệu đã được sửa đổi. Bản triển khai SQLite tham chiếu xác định dữ liệu đầu ra có đúng hay không.
Theo kết quả OpenAI được The New Stack tổng hợp, GPT-6 Astra vượt mức 83% ở 19 trong số 20 ngôn ngữ và cải thiện kết quả ở tất cả ngôn ngữ được thử nghiệm. Tỷ lệ vượt qua kiểm thử trung bình của mô hình là 87,4%, cao hơn mức 26,8% của GPT-5.6 Sol.
Kết quả của GPT-6 Luna
GPT-6 Luna, lựa chọn có chi phí thấp hơn, đạt tỷ lệ trung bình 40,3%. Mô hình này vượt GPT-5.6 Sol ở mọi ngôn ngữ trong bài thử. Chi phí giao diện lập trình ứng dụng của Luna được ước tính thấp hơn khoảng 78%, theo số liệu OpenAI được The New Stack dẫn lại.
Kết quả bổ sung bằng chứng rằng trí tuệ nhân tạo đang hạ thấp rào cản xây dựng phần mềm bằng nhiều ngôn ngữ. Dù vậy, một bộ kiểm thử có cấu trúc không phản ánh đầy đủ mã nguồn riêng, quy tắc nghiệp vụ và các phụ thuộc tích lũy qua nhiều năm trong phần mềm sản xuất.
Điểm số cao chưa thay thế được việc kiểm chứng
MultiLangBench có mã và bộ kiểm thử công khai, còn bài đánh giá di chuyển COBOL thì không. Khi thiếu ca kiểm thử và tập dữ liệu nền, các nhóm bên ngoài không thể tự xem xét cách OpenAI chấm điểm, tái tạo kết quả hoặc xác định những loại chương trình mà mô hình xử lý chưa tốt.
Một thước đo khác cho thấy thứ hạng mô hình có thể thay đổi theo phương pháp đánh giá. Real-SWE 1.1 sử dụng các kho mã riêng. Tính đến thứ Năm được nêu trong bài gốc, thước đo này xếp Claude Opus 5.5 đứng đầu với tỷ lệ giải quyết 56,8%. Một lần chạy Real-SWE trước đó do The New Stack đưa tin có mô hình dẫn đầu khác và điểm số thấp hơn.
OpenAI thừa nhận rằng kết quả áp dụng vào phần mềm sản xuất vẫn cần chuyên gia rà soát và kiểm thử dựa trên quy tắc nghiệp vụ cùng các phụ thuộc của hệ thống. Vì vậy, hoạt động rà soát mã do trí tuệ nhân tạo tạo ra vẫn là một phần cần thiết của quá trình triển khai.
OpenAI không phải công ty đầu tiên đưa trí tuệ nhân tạo vào hiện đại hóa COBOL. Theo The New Stack, Anthropic trình bày cách Claude Code có thể hỗ trợ công việc này vào ngày 23/2, còn AWS giới thiệu các tác tử phục vụ di chuyển hệ thống máy tính lớn trong năm 2024.
Hãy theo dõi Sine để cập nhật các bước tiến của công cụ lập trình bằng trí tuệ nhân tạo và những giới hạn cần kiểm chứng trước khi đưa chúng vào hệ thống thực tế.
