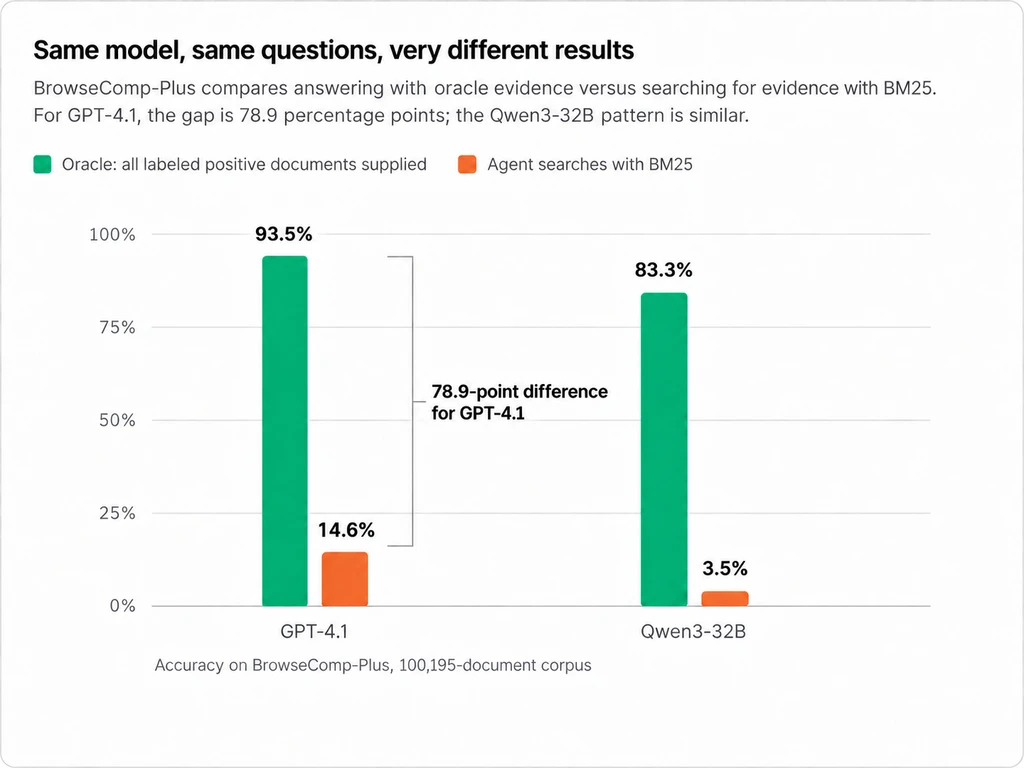
AI tác tử có thể thất bại không phải vì mô hình thiếu năng lực, mà vì lớp truy xuất không tìm được bằng chứng cần thiết. Trên BrowseComp-Plus, GPT-4.1 trả lời đúng 93,49% khi được cấp tài liệu hỗ trợ, nhưng chỉ đạt 14,58% khi phải tự tìm bằng BM25. Vì vậy, đội phát triển nên kiểm tra truy vấn, kết quả truy xuất và quyền điều khiển công cụ trước khi nâng cấp mô hình.
Phát hiện chính
Theo phân tích của The New Stack về bài toán truy xuất của AI tác tử, năng lực mô hình không thể bù cho bằng chứng mà tác tử không tìm thấy. Kết quả chênh lệch rõ rệt giữa hai điều kiện. Chất lượng truy xuất vì thế có thể quyết định toàn bộ nhiệm vụ.
- Theo nghiên cứu BrowseComp-Plus, GPT-4.1 đạt 93,49% trong chế độ được cấp tài liệu hỗ trợ và 14,58% khi dùng BM25.
- Theo nghiên cứu BrowseComp-Plus, Qwen3-32B giảm từ 83,25% xuống 3,49% trong cùng hai điều kiện đánh giá.
- Một nhiệm vụ tác tử có thể phát sinh hàng trăm hoặc hàng nghìn thao tác truy xuất.
- Giao diện truy xuất cần cho tác tử chọn bộ lọc, phương pháp truy xuất và cấu hình xếp hạng phù hợp.
Nội dung: Vì sao truy xuất là điểm nghẽn của AI tác tử
AI tác tử phụ thuộc vào truy xuất trong suốt quá trình thực hiện nhiệm vụ. Mỗi kết quả được tìm thấy có thể thay đổi truy vấn tiếp theo, bằng chứng được đưa vào ngữ cảnh và câu trả lời cuối cùng. Sai sót ở lớp truy xuất vì thế có thể tích lũy ngay cả khi mô hình suy luận đủ mạnh.
BrowseComp-Plus tách năng lực mô hình khỏi chất lượng truy xuất
Bộ chuẩn tách khả năng trả lời của mô hình khỏi khả năng tìm bằng chứng. Kho dữ liệu cố định gồm 100.195 tài liệu và 830 câu hỏi nghiên cứu. Các tài liệu hỗ trợ đã được con người xác minh.
Một tác tử có thể hoạt động thuyết phục trong buổi trình diễn được kiểm soát. Kho tài liệu khi đó thường sạch, nhiệm vụ quen thuộc và nội dung liên quan tương đối dễ tìm. Môi trường vận hành thực tế không gọn gàng như vậy. Tài liệu có thể bị trùng, bản nháp cũ vẫn xuất hiện trong kết quả và nhiều nhóm dùng những thuật ngữ khác nhau cho cùng một vấn đề.
Nhiều phiên bản của một chính sách cũng có thể cùng tồn tại. Trong khi đó, nhiệm vụ thực tế có thể phát triển theo những hướng chưa từng xuất hiện trong tập đánh giá. Tác tử vì thế dễ nhận tài liệu thiếu, lỗi thời hoặc không liên quan. Một mô hình thông minh hơn vẫn không thể suy luận đúng từ bằng chứng mà nó chưa bao giờ nhận được.
Cách bộ chuẩn phân tách hai loại lỗi
Nghiên cứu BrowseComp-Plus đánh giá tác tử trên kho dữ liệu cố định thay vì một dịch vụ tìm kiếm trên web luôn thay đổi. Thiết kế này giúp nhóm nghiên cứu phân biệt lỗi do mô hình không trả lời được với lỗi do tác tử không tìm thấy tài liệu cần thiết.
Trong một cách đánh giá, mô hình được nhận trực tiếp toàn bộ tài liệu tích cực đã gắn nhãn. Bài nghiên cứu gọi đây là chế độ tiên tri. Ở cách còn lại, tác tử phải tự tìm trong kho dữ liệu và thu thập những gì cần thiết.
Kết quả do BrowseComp-Plus công bố cho thấy GPT-4.1 đạt 93,49% trong chế độ tiên tri, nhưng giảm còn 14,58% khi tác tử dùng phương pháp cơ sở BM25. Với Qwen3-32B, tỷ lệ tương ứng giảm từ 83,25% xuống 3,49%.
Kết quả ở chế độ tiên tri phản ánh khả năng trả lời của mô hình khi tài liệu cần thiết đã nằm ngay trước nó. Với người thiết kế hệ thống, so sánh các phương pháp truy xuất còn cho biết liệu tác tử có tìm được bằng chứng với số lượt tìm hợp lý hay không. Khi giữ nguyên mô hình suy luận, truy xuất tốt hơn vừa nâng tỷ lệ trả lời đúng, vừa giảm số lần tìm kiếm.
Bài học thực tế là kiểm tra thứ gì đang được đưa tới mô hình trước khi thay mô hình. Một hệ thống mạnh nhưng nhận kết quả truy xuất kém vẫn chỉ có tài liệu kém để suy luận.
Một nhiệm vụ có thể tạo ra hàng nghìn lượt truy xuất
Tìm kiếm của AI tác tử không phải một lần tra cứu riêng lẻ. Perplexity mô tả những nhiệm vụ có thể kích hoạt hàng trăm hoặc hàng nghìn thao tác truy xuất trong vài phút, gồm các lượt tìm song song, hợp nhất kết quả và truy vấn tiếp nối.
Trong nghiên cứu Tìm kiếm dưới dạng mã của Perplexity, tác tử chia nhiệm vụ thành nhiều lượt tìm, chạy chúng song song, hợp nhất kết quả rồi đặt truy vấn tiếp theo dựa trên những gì vừa phát hiện. Hoạt động truy xuất vì thế kéo dài xuyên suốt quy trình thay vì kết thúc sau truy vấn đầu tiên.
Nếu tác tử chạy đồng thời mười lượt tìm kiếm và cần đủ cả mười kết quả mới có thể tiếp tục, lượt chậm nhất sẽ quyết định tốc độ của bước đó. Khi mô hình lặp lại cách làm này nhiều lần, độ trễ ở phần đuôi của phân phối trở nên quan trọng hơn nhiều so với một truy vấn tương tác đơn lẻ.
Áp lực tương tự xuất hiện ở năng lực xử lý. Một yêu cầu của người dùng có thể sinh ra hàng trăm thao tác tìm kiếm, trong khi nhiều tác tử khác cũng hoạt động đồng thời. Nếu chỉ đo số yêu cầu từ người dùng, dịch vụ có vẻ chưa chịu tải lớn dù lớp truy xuất đang xử lý khối lượng công việc cao hơn nhiều.
Sai sót ở bước đầu có thể lan sang các bước sau
Con người đánh giá kết quả tìm kiếm bằng bối cảnh được tích lũy qua thời gian. Họ biết nguồn nào đáng tin và thường nhận ra nội dung lỗi thời hoặc lạc đề. Tác tử bắt đầu với ít bối cảnh hơn, gần giống một nhân viên trong ngày đầu đi làm. Tác tử phải hình thành hiểu biết từ chính bằng chứng tìm được trong nhiệm vụ. Nếu một kết quả ban đầu sai, truy vấn tiếp theo cũng có thể đi sai hướng.
Mô hình minh họa xác suất lỗi tích lũy
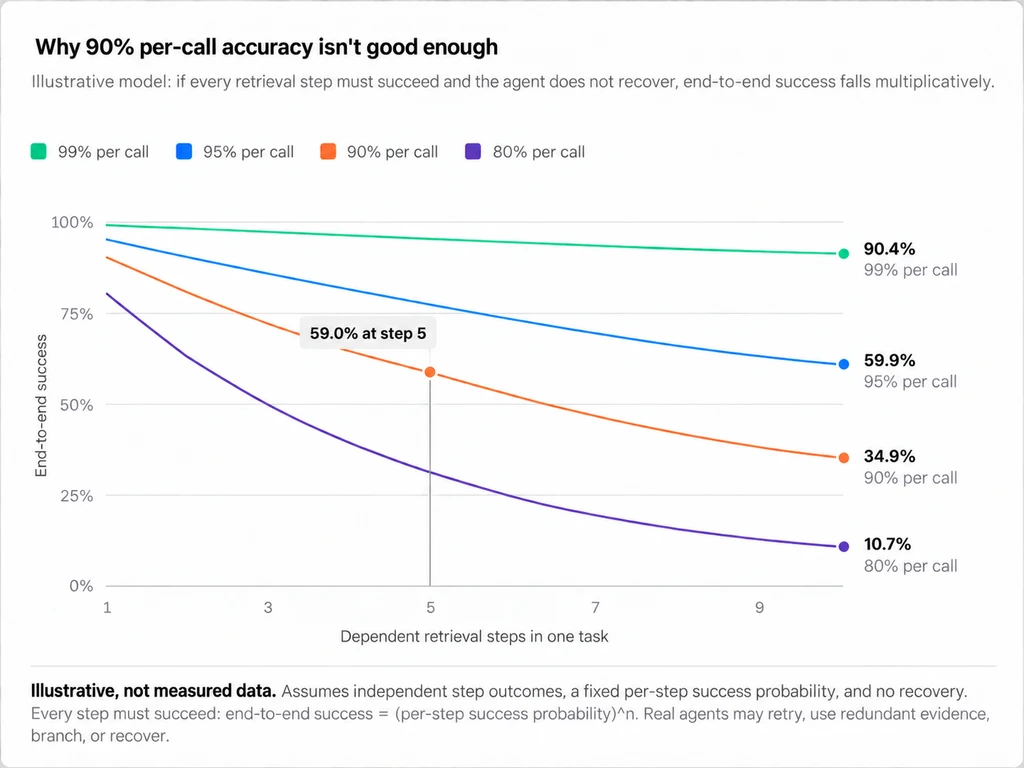
Số liệu từ bài phân tích của The New Stack cho biết mô hình minh họa giả định mỗi bước có xác suất 90% cung cấp đúng nội dung cần thiết. Với quy trình gồm năm bước, không có cơ chế thử lại hoặc phục hồi, xác suất để cả năm bước cùng thành công là 0,9 lũy thừa 5, tương đương khoảng 59%.
Đây không phải tỷ lệ thành công đo được của một tác tử thực tế. Tác tử có thể thử lại, đối chiếu nhiều bằng chứng, phân nhánh hoặc phục hồi sau lỗi. Phép tính chỉ minh họa cách một điểm yếu nhỏ ở từng bước có thể cộng dồn khi công việc phía sau phụ thuộc vào kết quả phía trước.
Tìm kiếm do tác tử điều khiển buộc lớp truy xuất xử lý nhiều truy vấn hơn cho mỗi nhiệm vụ, nhiều lượt tìm song song hơn và nhiều kết quả có khả năng chi phối các bước tiếp theo. Khi quy mô tăng, chất lượng truy xuất, độ trễ đuôi và năng lực xử lý đều trở thành một phần của bài toán.
Lớp truy xuất cũ được thiết kế cho một người dùng khác
Công cụ tìm kiếm truyền thống chủ yếu nhận truy vấn ngắn và trả về danh sách kết quả đã xếp hạng cho con người. AI tác tử có thể cần tạo bộ lọc, chỉ định thời gian, kết hợp nhiều phương pháp truy xuất và điều chỉnh truy vấn sau mỗi kết quả.
Tìm kiếm trên web đã có nhiều thập kỷ để thích nghi với hành vi của con người. Người dùng thường nhập truy vấn ngắn dù chưa hiểu rõ kho dữ liệu hoặc hệ thống tìm kiếm phía sau. Công cụ tìm kiếm vì thế đảm nhận phần lớn độ phức tạp, từ suy đoán ý định đến xếp hạng kết quả.
Tác tử có thể sử dụng một giao diện phong phú hơn. Nó có thể tìm cụm từ chính xác, tạo bộ lọc, chỉ định thời gian, nhóm kết quả, chọn chiến lược xếp hạng và đặt truy vấn tiếp theo từ những gì đã tìm được. Các lượt tìm có thể nối tiếp nhau khi tác tử thu hẹp phạm vi, mở rộng hướng điều tra hoặc xác minh câu trả lời.
Đầu vào của lớp truy xuất vì thế không chỉ là một chuỗi văn bản ngắn. Nó có thể gồm từ khóa, biểu diễn số của truy vấn, bộ lọc có cấu trúc hoặc nhiều thành phần kết hợp. Giao diện dành cho tác tử cần thể hiện rõ những lựa chọn này để tác tử dùng đúng phương pháp cho từng nhiệm vụ.
Đánh giá bằng truy vấn thực tế của tác tử
Cách đánh giá cũng phải thay đổi tương ứng. Một bộ truy xuất chủ yếu được kiểm tra bằng câu hỏi ngắn do con người viết có thể phản ứng khác khi tác tử tự tạo bộ lọc, từ tìm kiếm và truy vấn tiếp nối. Chất lượng cần được đo trên những truy vấn mà tác tử thực sự gửi trong môi trường vận hành.
Điều này đặc biệt quan trọng với các hệ thống AI tác tử vận hành trên Kubernetes, nơi tải tìm kiếm song song và độ trễ giữa các thành phần có thể ảnh hưởng trực tiếp đến toàn bộ quy trình. Trước khi đổi mô hình hoặc tinh chỉnh bộ truy xuất, đội vận hành nên xem chính các truy vấn thực tế trước.
Tác tử cần nhiều quyền điều khiển hơn một giao diện tìm kiếm hẹp
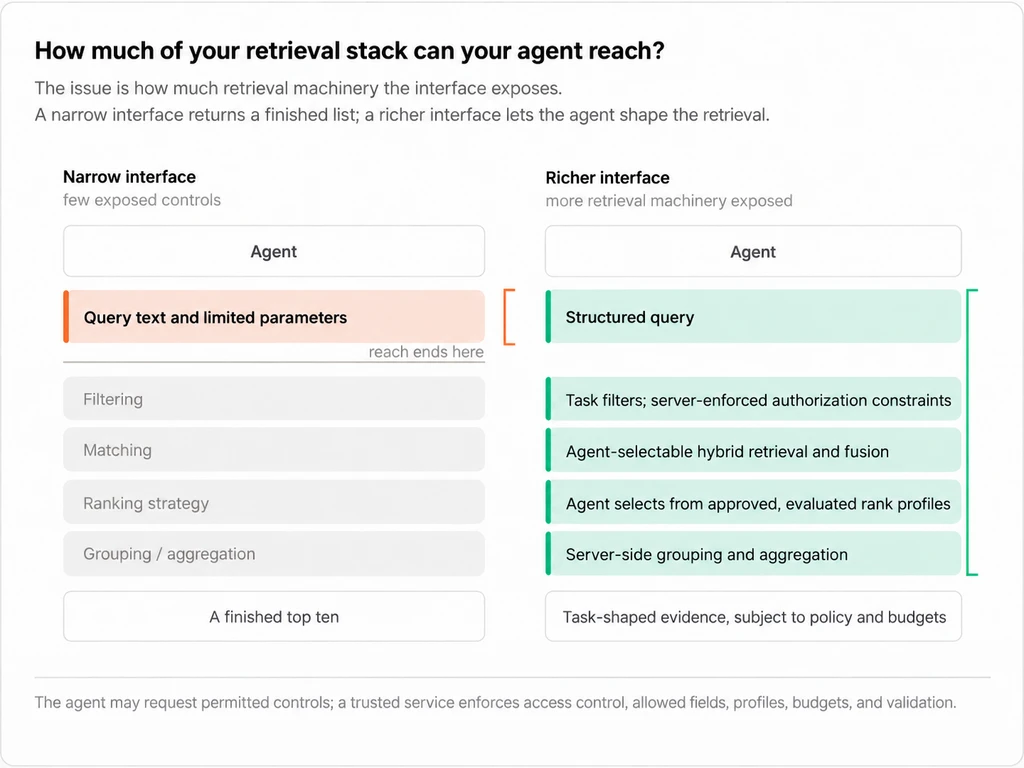
AI tác tử cần kiểm soát cách truy xuất và xếp hạng trong thời gian chạy khi nhiệm vụ thay đổi qua từng bước. Giao diện truy xuất phải cho phép tác tử chọn từ khóa, tìm kiếm ngữ nghĩa, bộ lọc, phép nhóm và cấu hình xếp hạng mà hệ thống đã cho phép.
Giao diện tìm kiếm truyền thống thường đưa ra một thỏa thuận đơn giản: gửi truy vấn, để máy chủ chạy quy trình truy xuất rồi nhận danh sách kết quả đã xếp hạng. Cách này phù hợp khi bên gọi chỉ cần đầu ra cuối cùng.
Vespa cung cấp khả năng điều khiển truy xuất qua ngôn ngữ truy vấn và các cấu hình xếp hạng. Bên gọi có thể kết hợp truy xuất theo từ khóa hoặc ngữ nghĩa với bộ lọc có cấu trúc, cách xếp hạng và phép nhóm trong cùng một yêu cầu.
Khả năng nội bộ phải được mở qua giao diện
Giao diện quyết định những gì tác tử có thể sử dụng. Một hệ thống có thể hỗ trợ lọc, tổng hợp, nhiều phương pháp truy xuất và nhiều cách xếp hạng ở bên trong. Các khả năng đó không giúp ích nếu tác tử không thể gọi chúng vào đúng lúc.
Quy trình cố định vẫn phù hợp với nhiều ứng dụng có phạm vi rõ ràng. Yêu cầu trở nên phức tạp hơn khi nhiệm vụ thay đổi từ bước này sang bước khác và tác tử cần hành vi truy xuất khác nhau trong thời gian chạy.
Mục tiêu không phải trao toàn bộ quyền cho mô hình. Hệ thống cần mở đúng bộ lọc, chiến lược xếp hạng và phép nhóm mà tác tử cần, trong khi việc phân quyền, xác thực, giới hạn ngân sách và các biện pháp bảo vệ khác vẫn nằm ở phía máy chủ đáng tin cậy.
Mở quyền điều khiển vẫn chưa đủ
Quyền truy cập vào nhiều công cụ truy xuất chỉ có ích khi tác tử hiểu công cụ nào đang có và trường hợp nào nên dùng. Nếu giao diện không mô tả trường dữ liệu, bộ lọc, phép nhóm và cấu hình xếp hạng, tác tử có thể quay lại truy vấn văn bản tự do.
Một bộ máy có thể hỗ trợ bộ lọc, đối sánh từ khóa, tìm kiếm láng giềng gần nhất, nhóm dữ liệu, tái xếp hạng và nhiều cấu hình xếp hạng. Tác tử chỉ sử dụng được những khả năng đó khi giao diện giải thích rõ cái gì đang có và trường hợp nào nên dùng.
Nếu trường có thể lọc, cấu hình xếp hạng hoặc phép nhóm không được mô tả, phần việc còn lại bị đẩy sang suy luận hoặc các lần gọi công cụ bổ sung.
Mô hình chuyển đổi truy vấn tạo thêm một khâu trung gian
Một cách xử lý là đặt mô hình chuyển đổi truy vấn giữa tác tử và hệ thống truy xuất. Mô hình này nhận yêu cầu rồi chuyển nó sang cú pháp của bộ máy tìm kiếm. Cách làm phù hợp khi ứng dụng muốn tập trung việc tạo truy vấn phía sau một giao diện ổn định.
Tuy nhiên, khi bên gọi đã là một tác tử, mô hình chuyển đổi tạo thêm một khâu trung gian. Tác tử ban đầu có nhiệm vụ, kết quả trước đó và các ràng buộc trong ngữ cảnh. Mô hình trung gian phải dựng lại ý định đó từ một yêu cầu hẹp hơn rồi chuyển thành truy vấn. Việc bàn giao làm tăng độ trễ và tạo thêm cơ hội làm mất hoặc làm sai ý định.
Một hướng khác là mô tả trực tiếp giao diện truy xuất cho tác tử, gồm các trường dữ liệu, ý nghĩa của từng trường và những cấu hình xếp hạng sẵn có. The New Stack gọi cách mô tả này là lược đồ sẵn sàng cho tác tử.
Từ lược đồ đến kỹ năng truy xuất
Lược đồ có thể trở thành tài liệu hướng dẫn để tác tử chọn trường, bộ lọc và phương pháp xếp hạng. Cách tiếp cận Schema-to-Skill kết hợp cấu trúc ứng dụng Vespa, hướng dẫn sử dụng bộ máy và kiến thức riêng của ứng dụng thành một tài liệu kỹ năng ngắn.
Một lược đồ tìm kiếm đã chứa phần lớn thông tin tác tử cần: tên và kiểu dữ liệu của trường, trường nào có thể tìm kiếm hoặc dùng làm bộ lọc, các cấu hình xếp hạng, cùng những mô hình và cấu trúc số đã thiết lập.
Lược đồ cần giải thích ý nghĩa nghiệp vụ
Phần còn thiếu là ý nghĩa nghiệp vụ. Một trường có tên tier có thể chỉ gói tài khoản, cấp độ dịch vụ hoặc một khái niệm khác. Trường thời gian published có thể là ngày xuất bản đầu tiên, ngày sửa gần nhất hoặc thời điểm dữ liệu được nhập. Một cấu hình mang tên exact cũng chưa cho tác tử biết loại truy vấn nào phù hợp với nó.
Khi những ý nghĩa này được bổ sung vào lược đồ, tác tử không chỉ nhìn thấy tên và kiểu dữ liệu. Tác tử có đủ bối cảnh để chọn trường, bộ lọc và phương pháp xếp hạng phù hợp với nhiệm vụ.
Schema-to-Skill bổ sung hướng dẫn sử dụng
Quy trình Schema-to-Skill dùng lược đồ để cung cấp cấu trúc. Hướng dẫn của bộ máy giải thích cách dùng các khả năng một cách an toàn. Kiến thức ứng dụng bổ sung từ vựng và ý nghĩa không thể suy ra chỉ từ tên trường.
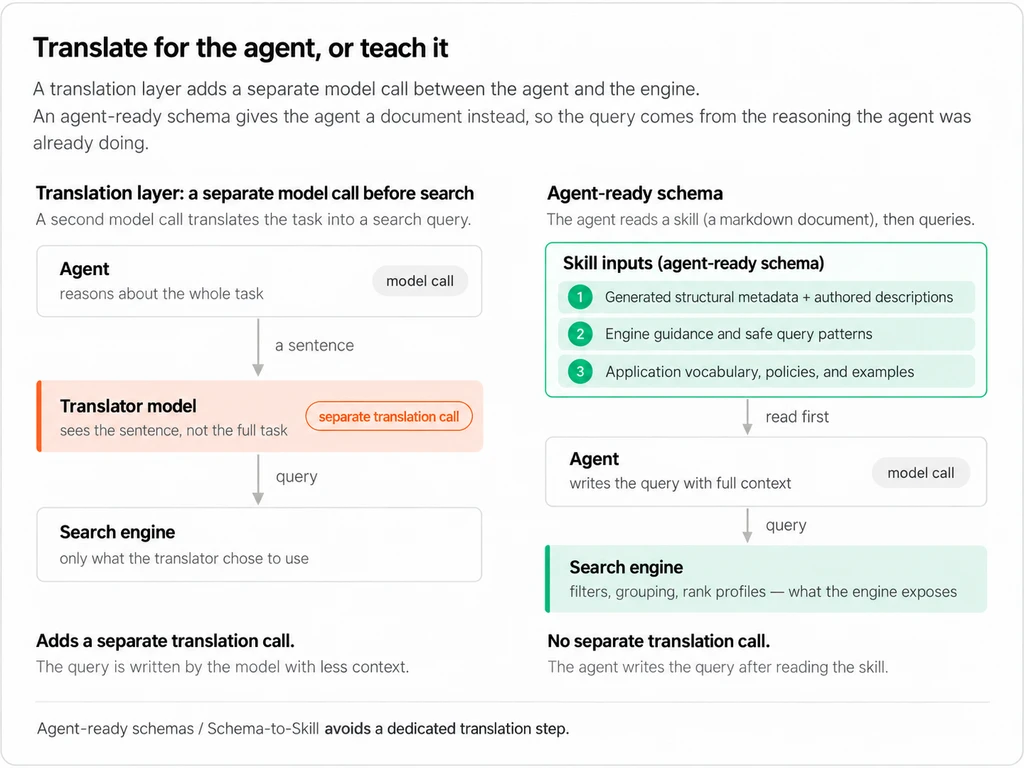
Tác tử tham khảo tài liệu kỹ năng để chọn chiến lược mà ứng dụng Vespa cho phép. Vespa vẫn thực hiện công việc trên kho dữ liệu, gồm đối sánh, lọc, xếp hạng và tổng hợp. Tác tử quyết định cần hỏi gì, còn hệ thống truy xuất thi hành yêu cầu đó.
Cách tiếp cận này liên quan trực tiếp đến hạ tầng AI và cách vận hành các thành phần của hệ thống. Truy xuất không còn là tiện ích đứng ngoài mô hình. Nó ảnh hưởng đến bằng chứng tác tử nhìn thấy, lượng ngữ cảnh phải mang theo, số lần tìm lại và khả năng hoàn thành nhiệm vụ.
Mô hình tốt hơn vẫn có ích, nhưng tác tử tiếp tục thất bại nếu tìm sai bằng chứng, không thể diễn đạt chiến lược truy xuất cần thiết hoặc không hiểu hệ thống tìm kiếm mà nó đang gọi. Khi truy xuất diễn ra trong suốt nhiệm vụ, mỗi kết quả đều có thể thay đổi bước kế tiếp.
Cần kiểm tra gì trước khi nâng cấp mô hình?
Trước khi thay mô hình, đội phát triển nên kiểm tra các truy vấn do tác tử tạo ra, bằng chứng mà lớp truy xuất trả về và những quyền điều khiển được mở qua giao diện. Việc đánh giá cũng cần dùng chính kiểu truy vấn và tải song song xuất hiện trong môi trường vận hành.
- Đối chiếu tài liệu được truy xuất với bằng chứng cần thiết để hoàn thành nhiệm vụ.
- Kiểm tra tài liệu lỗi thời, trùng lặp hoặc không liên quan có đang được xếp hạng cao hay không.
- Đo số lượt tìm kiếm, truy vấn song song và độ trễ của lượt chậm nhất.
- Xác nhận tác tử có thể dùng đúng bộ lọc, phép nhóm và cấu hình xếp hạng.
- Mô tả ý nghĩa nghiệp vụ của trường dữ liệu thay vì chỉ cung cấp tên và kiểu dữ liệu.
Nếu tác tử không tìm được bằng chứng đúng hoặc không biết cách điều khiển hệ thống tìm kiếm, nâng cấp mô hình sẽ không giải quyết được nguyên nhân chính của lỗi.
